はじめに
ローカル画像生成AI界隈に新たなモデルが登場し、注目を集めています。ローカル画像生成モデルで画像内に文字を入れるのは、これまで困難な場合が多かった印象です。2026年10月16日、そうした課題に正面から取り組んだオープンウェイトの画像生成モデル「MOSS-Image」が公開されました[1]。画像内に長い文章を描画できることと、JSONで「どこに何を置くか」を指定できる点を大きな特徴としています。
この記事では、公式のGitHub、Hugging Faceのモデルカード、arXivの技術報告などの一次資料で確認できた情報を中心に、仕組み、性能、動かし方、ライセンス、未確認の点までを整理します。ベンチマークの数値は、すべて開発元(OpenMOSS/MOSI.AI)による評価です。
MOSS-Imageの概要
誰が作ったモデルか
MOSS-Imageの技術報告の著者名義は「MOSI.AI」で、著者にはMOSI Intelligence、SII、復旦大学、上海交通大学の4つが並んでいます[2]。コードはGitHubの「OpenMOSS/MOSS-Image」、重みはHugging Faceの「OpenMOSS-Team」名義で配布されており[1][3]、公式サイトでは「OpenMOSSのテキストから画像を作るモデルファミリー」と紹介されています[4]。
公開の経緯
公式のGitHub READMEのNews欄によると、主な出来事は次のとおりです[1]。
- 2026年10月16日:MOSS-Image-BaseとMOSS-Image-SFTを発表し、コードと重みを公開。同じ日にSGLang、vLLM-Omni、ComfyUIが対応(day-0対応)
- 2026年10月18日:コミュニティ製の学習ツール「KohakuMossTrainer」が公開(最小6GBのVRAMでアダプター学習ができると紹介)
- 2026年10月19日:技術報告がarXivで閲覧できるようになったと告知
- 2026年10月20日:MOSIのAPIプラットフォームでMOSS-Imageシリーズの提供を開始
なお、arXivのページ上の投稿日は2026年10月16日(arXiv 2610.23374)です[2]。
BaseとSFTの2種類のモデル
公開されたモデルは2種類です。
- MOSS-Image-Base:ベースの画像生成モデル。ユーザーガイドによると、事後学習もCFGなどの蒸留も行っておらず、コミュニティがLoRAを学習しやすくするためだと説明されています[5]
- MOSS-Image-SFT:Baseを選別したデータで追加学習(ファインチューニング)したモデル[1][3]
公式が示す両者の違いは、ホワイトボードの作例で「SFTのほうが文字のまとまりがはっきりし、配置も整っている」という点だけで[1][3]、SFTの学習データ量や手順は確認できませんでした。ASCII.jpは、通常の画像生成ではSFTを勧めています[6]。
仕組みと特徴
生成本体は5Bの単流DiT
技術報告によると、生成本体はゼロから事前学習した5B(50億パラメータ)の拡散Transformer(DiT)で、主な構成は次のとおりです[2]。
- 生成本体:42ブロック、hidden size 3072、24ヘッド×128次元
- テキストエンコーダー:Qwen3.5-9B
- VAE:FLUX.2のVAE(凍結、FLUX.2-klein-4Bから読み込み)。実質16ピクセル四方で1トークン(1024×1024なら4096トークン)
注意したいのは、「5B」は生成本体だけの数字で、テキストエンコーダーとVAEを含まないことです[2]。実際に動かすときは9Bのテキストエンコーダーも読み込みます。
長い文字の描画とJSONによる配置の制御
READMEでは、配置の制御、文字の描画、最大4Kトークンのプロンプト、アニメ調と写実調への対応、追加学習のしやすさなどを特徴に挙げています[1]。中でも目立つのがJSONによるレイアウト指定です。プロンプトは自然文、タグ列、JSONレイアウトの3形式に対応し、組み合わせもでき、JSONレイアウトは「実験的」機能とされています[5]。
公式の例(1024×1024用)は次のとおりです[1][5]。
{“summary”:{“meta”:[“poster”],”canvas”:”single”,”caption”:”A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top.”},
“items”:[
{“label”:”text”,”caption”:”Large dark-blue uppercase title centered at the top.”,”text”:”EXPLORE”,”bbox”:[-416,-384,-288,384]},
{“label”:”object”,”caption”:”A flat blue mountain illustration in the lower center.”,”bbox”:[-192,-288,384,288]}],
“bbox_coord_space”:”abs_centralized”,”bbox_format”:”yxyx”}
summary.caption に全体の場面と画風、items に要素ごとの種類・見た目・位置(bbox)を書き、文字には text を付けます。座標は [y_min, x_min, y_max, x_max] の順で、画像の中心を原点にしたピクセル値です(xは右、yは下が正)[5]。座標は出力サイズと合わせる必要があります[1]。
学習データと学習段階の報告
学習データはReLAION、OmniCorpus、DataCompなどの公開データセットから作られ、重複とAI生成画像を除いて約50億枚から約30億枚に絞り込まれました[2]。それ以上の品質フィルタはかけず、透かしやぼけはキャプションに書き込んで学習させたと説明されています(元データ側のNSFWや透かしのチェックは残っている)[2]。画像内の文字の改行もキャプションに保持し、技術報告は「文字の改行もレイアウトの一種」と表現しています[2]。
学習段階では解像度を256ピクセル級から最大約2×1024²まで、テキスト上限を320から4096トークンまで段階的に上げています。表(Table 1)では4段階、本文は「3段階」と書いていて、技術報告の中で表記が食い違っています[2]。最適化はMuonとAdamWの組み合わせで、1Bモデルの比較実験ではAdamWより28.6〜33.2%少ないステップで同じlossに達したとされています[2]。
技術報告では、短い依頼を内容と配置の詳しい指定(JSON)に書き換える「エージェント型のプロンプト強化(Layout PE)」を組み合わせたシステムとしてMOSS-Imageを説明しており、Layout PEは推論時にGPT-6を使います[2]。GitHubにはGPT-6系エージェント向けの「Prompt Enhancer」スキルも公開されています[1]。
モデルの性能
以下の数値はすべて技術報告に載っている開発元自身の評価です。7Bench、LLTB、RLAは開発元が自分で評価したと明記されています[2]。
長文の描画:LongLongTextBench(LLTB)
LLTBは開発元が新しく作った長文描画のベンチマークで、英語と中国語の文学テキスト各120課題、1課題の平均は1,339.8字です。OCRで文字の再現度を測り、6グループの平均(Mean-6)を出します。結果(%)は次のとおりです[2]。
- GPT Image 2(クローズド):99.0
- Nano Banana Pro(クローズド):96.6
- MOSS-Image:96.3
- Qwen Image 3.0 Pro(クローズド):94.3
- Qwen Image 2512:64.9
- FLUX.2:11.8
技術報告は96.3を「表のオープンウェイトモデルで最高」としていますが、最も長い中国語の条件では92.4に下がります[2]。
配置の制御:7Bench
配置の制御を測る7Bench(mIoUdetとLayout AUC)の結果です[2]。
- MOSS-Image:mIoUdet 0.88、Layout AUC 0.70
- Ideogram 4.0:0.44、0.20
- Nano Banana Pro:0.33、0.16
- GPT Image 2:0.30、0.16
MOSS-Imageは両方の指標で評価した全モデルを上回ったとされています。ただし、GPT Image 2は224件中22件が安全上ブロックされ、IoU 0で計算されています[2]。
人による比較:RealLayoutArena(RLA)
RLAは、ポスターやインフォグラフィック、UIの計61課題で、モデル名を隠した2枚を人が比べてEloを出す評価です[2]。
- システム全体の比較:GPT Image 2が1844.4で1位、MOSS-Image+Layout PEが1698.7で2位[2]
- 生成本体だけの比較(同じ拡張済みプロンプトを使用):MOSS-Imageが1807.3で1位、ERNIE Imageが1748.5[2]
- プロンプトの書き方の比較(MOSS-Image):JSONレイアウトが1622.9で最も高く、短い依頼は1081.7にとどまりました[2]
開発元の評価の範囲では、短い依頼より、内容と配置を詳しく書いたプロンプト、特にJSONのほうが良い結果になっています。なお、BaseとSFTのどちらで測ったかは確認できませんでした。
使い方と動作環境
公式に案内されている動かし方
- Python(Diffusers):Python 3.10以上、CUDA対応のNVIDIA GPU、PyTorch 2.9以上、diffusers 0.38以上、transformers 5.3以上が必要です[3]
- Gradio:python gradio_app.py –model OpenMOSS-Team/MOSS-Image-Base で起動し、メモリモードを4つから選べます[1]
- ComfyUI:10月16日にネイティブ対応が取り込まれ、commit e087d8f6 以降のmaster/nightlyが必要です(10月19日時点でv0.41.3には未収録)[7]。重みはComfy-Orgが配布しています[8]
- SGLang:検証済みなのはBaseで、SFTは「ここでは検証していない」とされ、画像編集は実装されていません[9]
- vLLM-Omni:/v1/images/generations のAPIでBaseとSFTを提供するレシピがあります[10]
- Mac(実験的):MPSで動かす手順があり、検証はM1 Max/32GBとSFTの組み合わせ。モデル一式で約25GB、空きディスクは約40GBが目安です[11]
推奨設定
公式のユーザーガイドが勧める設定は次のとおりです[5]。
- 解像度:合計100万〜200万ピクセル程度、縦横は16の倍数
- ステップ数50以上、CFG 3.0(短いプロンプトでは上げる)、shift 5.0、サンプラーはEuler
- SLG(Skip Layer Guidance):22層目(0始まり)のスキップを推奨。切ると写実的になるが、細部が崩れることがある
- 推奨ネガティブプロンプト:nsfw, worst quality, bad anatomy, watermark, jpeg artifact
- 言語:英語を推奨(中国語や他の言語にも対応)
ユーザーガイドに日本語の明記はありませんが[5]、ASCII.jpは日本語のプロンプトも認識すると報告しています[6]。描きたい文字は \n や実際の改行で行を明示すると制御しやすく[5]、技術報告でも改行の明示で文字の描画が良くなったとされています[2]。
必要なメモリ
READMEには、1024×1024・50ステップ1枚のピーク使用量としてGPUメモリ3.65GiB、システムRAM 14.00GiBという計測値があり、DiTをCPUのRAMに置く省メモリ(minimal)設定の説明に続けて書かれていますが、どのモードの値かは明記されていません[1]。Comfy-Orgの配布ファイルは、生成本体がbf16で約10.2GB(int8で約5.4GB)、テキストエンコーダーがbf16で約19.3GB(int8で約9.7GB)です[8]。
ライセンスと商用利用
モデルカードには、重みと同梱の推論コードがApache License 2.0で公開されていると書かれています[3]。公式サイトは、重みはApache-2.0で、第三者のコンポーネントはそれぞれのライセンスに従うとしています[4]。ASCII.jpも、商用利用・改変・再配布を認めるライセンスだと紹介しています[12]。ただし、Qwen3.5-9BやFLUX.2由来のVAEのライセンスが商用利用にどう影響するかは確認できていないため、商用で使う前に各コンポーネントのライセンスを確認してください。
試してみたい人向けのプロンプト例(未検証)
以下は、この記事の材料にした調査レポートで作られた例です。実際に生成して検証したものではありません。公式の書き方に沿っていますが、結果は保証できません。
文字入りポスター(日本語の自然文):
淡い灰青色の紙に印刷したミニマルな文芸ポスター。上部右寄りに太い墨色の大見出し「雨を待つ」。その下に小さく2行で
「神保町ギャラリー
2026年12月5日 18時開場」
中央下に赤い傘のシルエットを1つ。静かな余白を広く残す。指定以外の文字やロゴは描かない。
縦書きの文芸ポスター(JSON、768×1344用。yは-672〜672、xは-384〜384):
{“summary”:{“meta”:[“poster”],”canvas”:”single”,”caption”:”A restrained Japanese literary poster on pale blue-gray paper, with subtle paper grain and a single red umbrella silhouette near the lower center. Draw only the listed text. No ruby, no furigana, no extra logos.”},
“items”:[
{“label”:”text”,”caption”:”large dark-ink brush title, vertical, one column, upper right”,”text”:”雨を待つ”,”bbox”:[-560,180,40,330]},
{“label”:”text”,”caption”:”small vertical event details, two short lines, below the title”,”text”:”神保町ギャラリー\n2026年12月5日 18時開場”,”bbox”:[-360,80,260,160]},
{“label”:”object”,”caption”:”single flat red umbrella silhouette near the lower center”,”bbox”:[180,-120,420,120]}],
],
“bbox_coord_space”:”abs_centralized”,”bbox_format”:”yxyx”}
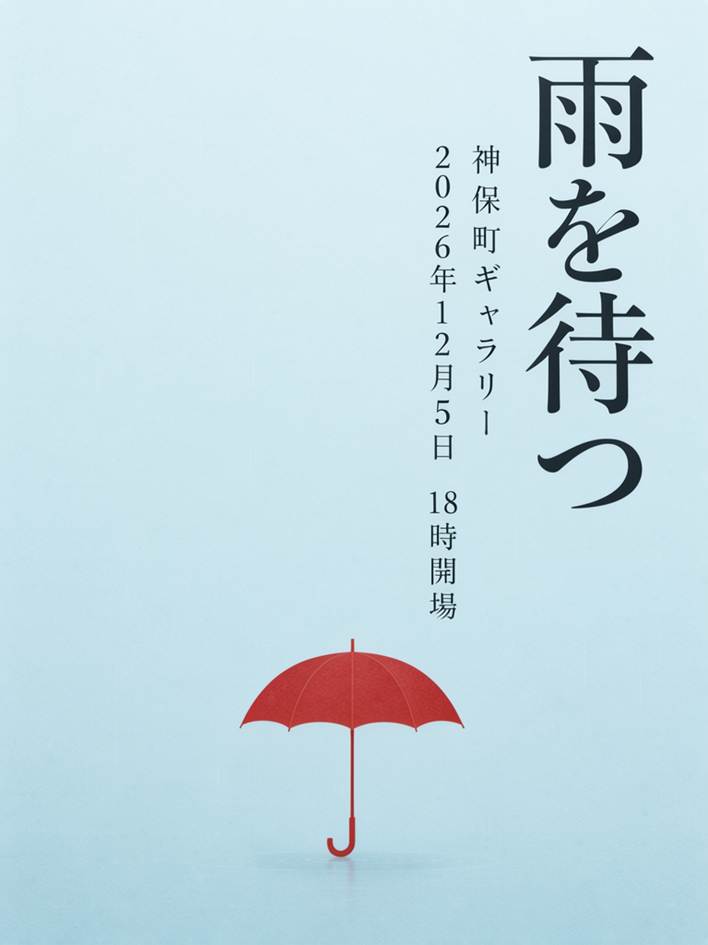
著者がComfy-OrgのComfyUI用モデルを用いて作りました。
生成の設定は、公式の推奨(50ステップ以上、CFG 3前後、shift 5、SLGは22層目)から始めるのが無難です[5]。アニメ調のタグ列で書く場合は、公式が勧める順序(Quality→Score→Meta→Year→Character→Series→Artist→General)を意識するとよいでしょう[5]。
まとめ
MOSS-Imageは、5Bの生成本体と9Bのテキストエンコーダーを組み合わせたオープンウェイトの画像生成モデルです。開発元の評価では、長文の描画(LLTB 96.3)と、JSONによる配置制御(7Bench mIoUdet 0.88)が大きな強みとされています[2]。重みはApache-2.0ライセンスで公開され、ComfyUIなども公開初日から対応しました[1]。
ローカル画像生成コミュニティでは、クラウド上のモデルと比べて、ローカル環境に適した画像生成モデルが継続的に登場してこなかったため、選択肢に飢えているという印象があります。しかし、このMOSS-Imageの登場によってコミュニティが活発化している様子がうかがえます。今後、派生モデルが数多く生まれ、ローカル画像生成の発展につながることを期待します。
参考文献
- OpenMOSS「MOSS-Image」GitHubリポジトリ(README) https://github.com/OpenMOSS/MOSS-Image
- MOSI.AI「MOSS-Image Technical Report」arXiv:2610.23374 https://arxiv.org/abs/2610.23374
- OpenMOSS-Team「MOSS-Image-SFT」Hugging Faceモデルカード https://huggingface.co/OpenMOSS-Team/MOSS-Image-SFT
- OpenMOSS「MOSS-Image: Text-to-Image Generation with Native Layout Control」公式サイト https://openmoss.ai/MOSS-Image/
- OpenMOSS「MOSS-Image-Base User Guide」(USERGUIDE.md) https://github.com/OpenMOSS/MOSS-Image/blob/main/USERGUIDE.md
- ASCII.jp「無料の画像生成AI『Moss-Image』がすごい 日本語も漫画も生成、商用利用OKの実力を試した」(2/4ページ、2026年10月26日) https://ascii.jp/elem/000/004/445/4445534/2/
- OpenMOSS「MOSS-Image for ComfyUI」(comfyui/README.md) https://github.com/OpenMOSS/MOSS-Image/blob/main/comfyui/README.md
- Comfy-Org「MOSS-Image」Hugging Face https://huggingface.co/Comfy-Org/MOSS-Image
- SGLang Documentation「MOSS-Image」 https://docs.sglang.io/cookbook/diffusion/OpenMOSS/MOSS-Image
- vLLM Recipes「OpenMOSS-Team/MOSS-Image-Base」 https://recipes.vllm.ai/OpenMOSS-Team/MOSS-Image-Base
- OpenMOSS「Experimental Apple silicon inference (MPS)」(docs/macos.md) https://github.com/OpenMOSS/MOSS-Image/blob/main/docs/macos.md
- ASCII.jp「無料の画像生成AI『Moss-Image』がすごい 日本語も漫画も生成、商用利用OKの実力を試した」(1/4ページ、2026年10月26日) https://ascii.jp/elem/000/004/445/4445534/