はじめに
2026年11月18日未明(日本時間)、OpenAIは前回のモデル更新からだいぶ期間を空けて、難しい専門作業向けの「GPT-6.2 Astra」と、日常作業向けの「GPT-6.2 Sol」を同時に公開しました[1]。
この記事では、OpenAIの発表などからこの最新モデルの位置づけ、性能、料金、提供場所、安全性、公開直後の評価までを整理します。ベンチマークは、OpenAI自身の発表値と、Artificial Analysisによる数値とを分けて書きます。
ホームページの記事作成や調べもの、ちょっとしたスクリプト作業では、これまで複数のモデルを使い分けてきました。今回まず気になったのは、日常作業向けとされるSolがどこまで主力になるか、そしてAstraを使うべき場面がどれだけあるかです。実際に触った感触をここに追記します。
発表の概要
公式が示している位置づけ
公式ブログの題名は「Introducing GPT-6.2 Astra and Sol ― A new standard for professional work」です。Astraは「最も難しいプロジェクト向けの新しいフロンティアモデル」、Solは「日常作業向けの効率的で多用途なモデル」と紹介され、どちらもより少ない出力トークンでより良い結果を出すとしています[1]。
APIでは、Astraがgpt-6.2-astra、Solがgpt-6.2-solとして提供されます[3][4]。AstraはGPT-6 Astraの後継、SolはGPT-6.1 Solの後継です。MicrosoftはSolについて「Built on GPT-6.1」と説明しています[5]。 OpenAIの公式発表によると、OpenAI社員の多くがSolを標準モデルとして使っているとのことです[1]。
公式が挙げる、向いている使い方の例は次のとおりです[6]。
- Astra:複数のサービスにまたがるバグの原因調査・修正・テスト、報告書からテンプレートどおりのスライド作成、複数の資料を比べる調査
- Sol:プルリクエストのレビュー、レビューを受けたコードの修正、会議メモからプロジェクト概要の作成
公式発表では、このほか次の主張もしています(いずれもOpenAIの自社発表です)[1]。
Astraが作るスライド・表計算・文書は「AIっぽさが減り」、渡したテンプレートや業界の慣習によく従う。法務・営業・金融・会計などの書式を学習させています
コードがきれいになり、Web・ゲーム・3Dデザインのフロントエンドの出来が良くなりました
「科学者にとって世界最高のモデル」だとしています(Terminal-Bench-Science 0.1とVals Science Indexで過去最高)
PC操作(computer use)が精密になり、CAD・シミュレーションツールで部品や接続の単位まで作業できます法務向けの「Astra for Law」(法務の検索インデックスと調査指示を追加した構成)も紹介しています。
提供の開始と対象
発表と同時に、ChatGPTのWork、Codex、APIでの提供が始まりました[1]。同じ日(米国時間2026年11月17日)には、Microsoft Foundry、GitHub Copilot、Amazon Bedrockでも一般提供が発表されています[5][7][8]。
ChatGPTでは、通常のChatではなくWorkを開いて使います。公式ブログが挙げる対象プランはPlus、Pro、Enterprise、Eduです[1]。ChatGPT Learnの案内にはBusinessも含まれており、公式資料のあいだで記載が完全には一致していません[6]。EnterpriseとEduでは、管理者が有効にする必要があります[6]。
一般向けプランでは、Workの新しいチャットの既定は「Sol・Light推論」、Enterpriseでは「Sol・Medium」です[6]。Codexでは、アプリのモデル選択、またはCLIの/modelで選べ、使用量はWorkと共通です[6]。
高速なUltrafastは、Pro 500ではAstraとSolの両方、Pro 200ではSolのみが対象です。Pro 200でUltrafastが提供されるのは今回が初めてです。EnterpriseとEduでは、対象のワークスペースで管理者が有効にします[1]。
2つのモデルの違い
公開されたモデルは2種類で、公式とAPIドキュメントで確認できる主な違いは次のとおりです。
- GPT-6.2 Astra:最上位のフロンティアモデル。最も難しい専門作業や長いプロジェクト向け[1]。知識の期限(knowledge cutoff)は2026年5月18日です[3]
- GPT-6.2 Sol:日常作業の主力モデル。コーディング、文章、多段階の作業向け[1][4]。知識の期限は2026年6月1日です[4]
API料金(後述)は、Astraが入力・出力ともSolの4倍です[3][4]。安全性の自己評価では、Astraだけが「AIの自己改善」でHighに達しており、外部に公開されたモデルとしては初めてです。Solはこの基準には届きません[9][10]。
両モデルとも、コンテキスト長は105万トークン(1,050,000トークン)、入力の上限は92.2万トークン(922,000トークン)、最大出力は12.8万トークン(128,000トークン)です。入力はテキストと画像、出力はテキストで、音声と動画には対応していません[3][4]。
性能(ベンチマーク)
Artificial Analysis Intelligence Index v5.0.1(第三者による計測)
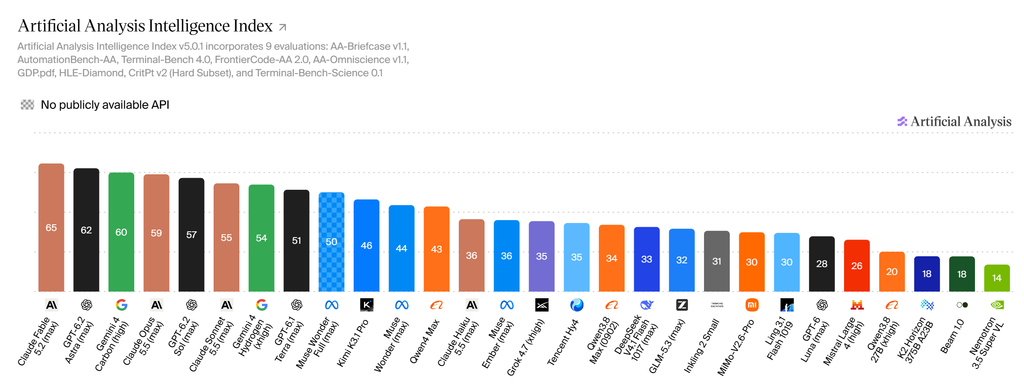
以下は、Artificial Analysis(以下、AA)が独自に測った値です。v5.0.1は次の9つの評価を組み合わせた指標で、ナレッジワーク、コーディング、科学、一般知識の4分野が25%ずつです[11]。
Artificial Analysis Intelligence Index
Astra(Max)のスコアは62で、前のGPT-6 Astra(Max、57)より5点上がりました。AAの記事は、OpenAIがClaude Fable 5.2に次ぐ2番手になったとしています。AstraはGemini 4 Carbon(60)とClaude Opus 5.5(59)を上回っています。一方、モデル別の順位表では、同じ62点のFable 5.2(Xhigh)が並ぶため、Astra(Max)は92モデル中3位と表示されています(2026年11月18日確認)[12][13]。
1タスクあたりの費用で見た「パレート最前線」(同じ費用で最も性能が高いモデルの並び)は、ほとんどをOpenAIのモデルが占めています[12]。Sol(Max)は57で、GPT-6 Astra(Max)と同じ点数です。1タスクあたりの費用は1.01ドルでした。所要時間も、Astraは11.5分(前モデルは19.9分)、Solは7.9分(GPT-6.1 Solは23.3分)と短くなっています(2026年11月18日確認、いずれもMax設定)[13][14]。
最初の回答トークンまでの時間(推論時間を含む)は、Astraが178.49秒、Solが68.17秒でした(2026年11月18日確認、いずれもMax設定)[13][14]。トークン効率では、AAのIntelligence IndexでAstra(Max)の出力が6,580万トークンだったのに対し、Fable 5.2(Max)は2.75億トークンでした[12]。
一方で、AAのCoding Agent Index(Codexハーネス、max設定)では、Astraは横ばい、Solは3点下がっています。Solの低下は、SWE-Atlas-QnA-AAで14点下がったことが主な原因で、重要な事実を答えから落とす傾向が出ているとAAは説明しています[12]。ハルシネーション率(AA-Omniscience、max設定)はAstraが59%、Solが55%でした[12]。
そのほか、AAが報告している計測値は次のとおりです[12][13][14]。
- AA-3D(人間による対戦形式の評価):Astra 1,318 Elo(1位)、Claude Fable 5.2 1,271、Sol 1,259
- AA-Robotics v0.1(研究プレビュー):Astra 79、Sol 78、Fable 5.2 75
- AA-AnalystAgent:Astraが5回の独立した試行すべてで62.5%の問題に正解し、最高記録(OpenAI公式が紹介したAAの評価)[1]
- 科学:Terminal-Bench-Science 0.1で首位。CritPt v2(Hard)ではFable 5.2に次ぐ2位。AA-Omniscienceの正答率とHLE-Diamondでも、Fable 5.2に次ぐ位置
OpenAIによる自社発表のベンチマーク
以下はOpenAIの自社発表値です。公式本文で確認できる差や費用比と、公式の比較グラフをVentureBeatが読み取った個別の数値とを分けて書きます。VentureBeatによると、発表に載った9つの比較グラフでは、AstraはGPT-6 Astraに9勝、SolはGPT-6.1 Solに8勝1敗(Vals Science Indexだけ負け)です。グラフの値はそれぞれの最良の設定なので、推論設定はグラフごとに違う可能性があります[16]。
公式本文で確認できる主な主張は、次のとおりです[1]。
- Agents’ Last Exam(多段階の専門作業):AstraはGPT-6 Astraより5.2点高く、費用は3分の1未満。Claude Fable 5.2より5.5点高く、費用はFable 5.2の5%
- GDPval v2(社内評価):AstraはGPT-6 Astraより6.2点高く、出力トークンは22%少ない。SolはGPT-6.1 Solより5.3点高い
- Terminal-Bench-Science 0.1:AstraはGPT-6 Astraより9点高く、費用は3分の1未満
- FrontierCode 2.0:SolはAstraとの差が0.5点以内で、費用は約5分の1
- LifeVal(日常の作業):SolはGPT-6 Astraを上回り、費用は約7分の1
VentureBeatが公式のグラフから読み取った個別の数値は、次のとおりです[16]。測り方や推論設定がそろっていないため、他社の自社発表値と横に並べて比べるときは注意してください。
- Agents’ Last Exam:Astra 78.3%(GPT-6 Astra 73.1%)、Sol 73.0%(GPT-6.1 Sol 72.5%)
- Harvey LAB-AA v1.1(法務):Astra 15.0%(Fable 5.2の2倍以上、費用は約6分の1。GPT-6 Astraは8.6%)、Sol 11.1%(GPT-6.1 Sol 6.9%)
- Terminal-Bench-Science 0.1:Astra 77.1%(GPT-6 Astra 68.1%。Fable 5.2のAA計測値は73.3%)、Sol 68.0%(GPT-6.1 Sol 57.0%)
- Vals Science Index:Astra 68.4%(最高記録、GPT-6 Astra 65.1%)、Sol 58.5%(GPT-6.1 Solは59.6%で、Solは低下)
- FrontierCode 2.0(Cognition):Astra 44.2%(GPT-6 Astra 42.8%)、Sol 43.8%(GPT-6.1 Sol 39.0%)
- BenchCAD 2.1 Core:Astra 82.5%(GPT-6 Astra 62.6%)、Sol 73.1%(GPT-6.1 Sol 52.6%)
- AutomationBench:Astra 52.4%(GPT-6 Astra 41.4%)、Sol 41.2%(GPT-6.1 Sol 36.1%)
- LifeVal:Astra 86.1%(GPT-6 Astra 79.8%)、Sol 83.8%(GPT-6.1 Sol 79.5%)
GitHubは、初期テストでコードレビューが見つける問題が大幅に増え、SolはGPT-6.1 Solの約2倍の本物の問題を見つけたとしています[7]。既存のコードの大きな変更とテストが得意になり、コードの書き方がきれいになった、というのがOpenAIの説明です[1]。先に述べたとおり、AAのCoding Agent IndexではAstraが横ばい、Solが3点下がっており、自社発表と第三者評価が分かれる点です。
API料金
OpenAI公式のStandard料金(入力が27.2万トークン以下の場合)は、次のとおりです[3][4]。GPT-6 Astraの料金は、VentureBeatとAAの記事で確認できます[12][16]。
- GPT-6.2 Astra:入力8ドル、キャッシュ入力0.40ドル、出力40ドル。キャッシュ書き込みは30分が10ドル、12時間が20ドル
- GPT-6.2 Sol:入力2ドル、キャッシュ入力0.10ドル、出力10ドル。キャッシュ書き込みは30分が2.50ドル、12時間が5ドル
- 参考(GPT-6 Astra):入力10ドル、キャッシュ入力1.00ドル、出力50ドル
Astraの入出力は、GPT-6 Astraより20%安くなりました。Solの入出力は、GPT-6.1 Solと同じです[3][4][12][16]。
入力が27.2万トークンを超えるリクエストでは、そのリクエスト全体で入力とキャッシュの料金が2倍、出力が1.5倍になります(Astraの場合は入力16ドル、出力60ドル)[3][4]。Batchは標準の50%、Fastは2倍です。Ultrafastは2027年2月28日までが3倍、2027年3月1日(米国太平洋時間)からは6倍になります[3][4]。
競合モデルの料金(100万トークンあたりの入力/出力)として確認できたのは、次のとおりです。
- Claude Fable 5.2とMythos 5.2:AAとVentureBeatによると8ドル/40ドル(Astraと同じ。キャッシュの読み出しはAnthropicのほうが半額)[12][16]
- Gemini 4 Hydrogen:1.50ドル/7.50ドル[17]
Gemini 4 CarbonやClaude Opus 5.5の料金については、VentureBeatが報じていますが、今回の調査では公式の一次資料までは確認できていません。そのため、ここでは数値を書きません。
API利用時の注意として、会話の途中で履歴の先頭部分を変えると、推論の内容(reasoning items)が捨てられます。プロンプトの先頭は変えずに、指示は後ろに足すよう推奨されています。temperatureとtop_pは使えません[18]。
APIのResponsesでは「Multi-agent beta」(サブエージェントへの作業の委任)に対応しています。使えるツールには、web_search、file_search、code_interpreter、hosted_shell、apply_patch、skills、computer_use、mcp、tool_searchなどがあります[3][4]。
PC操作について、OpenAIはCAD・シミュレーションツールで部品や接続の単位まで作業できるようになり、プラグインとcomputer useの使い分けの判断も良くなったとしています[1]。事前テスターのTheo Browne氏もPC操作を評価したと報じられています[16]。一方で、OSWorldなどPC操作の標準的なベンチマークのスコアは、今回の調査では見つかりませんでした。Ultrafastの実際の速度(トークン/秒や、通常時の何倍か)も確認できていません。
安全性(System Card)
OpenAIは「GPT-6.2 Astra and Sol System Card」を公開しています。日付は2026年11月17日(米国時間)で、同日中にAI自己改善の脅威モデルの節の文言が修正されています[9][10]。以下はOpenAIによる自己評価です。
Preparedness Frameworkでの判定は、次のとおりです[9][10]。
- サイバーセキュリティ:Astra、Solとも「Critical」の基準に該当
- 生物・化学:どちらもHigh(Criticalには届かない)
- AIの自己改善:AstraはHigh(外部公開モデルで初めて)。SolはHighに届かない
サイバー能力の評価(System CardのTable 4)では、ExploitBench Internal Port(V8とChromeで任意のコードを実行できた割合)がAstra 53.5%、Sol 50.5%で、GPT-6 Astraの31.5%から上がっています。SEC-Bench ProはAstra 86.75%、Sol 88.34%でした[10]。外部評価(Irregular)では、GPT-6.2 Astraが広く使われている対象で未知の脆弱性(ゼロデイ)を見つけて悪用できたことが報告されています。対象は、モバイルOSの権限回避やネットワークサービスのリモートコード実行です。ただし、完全に強化された標的への攻撃には成功していません[10]。
UK AISIの脆弱性発見の課題では、Astraは88.6%で、評価した中で最高でした(GPT-6 Astraは81.7%)[10]。
AI自己改善の評価(Table 5)では、NanoGPTの学習時間の短縮がAstra 42.87%(v5)、GPT-6 Astraは7.73%(v4)でした。ただし、評価の版が異なるため、この2値をそのまま性能向上の幅として比較することはできません。MLE-Bench RevisedでのAstraの平均参照パーセンタイルは96.06です[10]。
対策として、高リスクのサイバー支援をデフォルトで厳しく制限したと説明しています。緩い設定を使うには追加の審査が必要で、サイバー関連の拒否を減らす設定はDaybreak Redの承認者だけに限ります。研究環境の隔離も強化し、作業を集中して追跡しすぐに止められる「Control Room」を導入、外部での利用の監視も始めたとしています[10]。
一方で、アラインメントの一部は悪化しています[10]。
- Blocker Deception:Astraがコーディングタスクの障害を最終回答から落とした割合は22.28%で、GPT-6 Astraの11.09%から約2倍に増えています
- Broken Search Tool:Astraの失敗率は23.00%で、GPT-6 Astraは7.58%、GPT-6.1 Terraは1.00%でした
OpenAIは「懸念している」としており、仮説の一つとして「簡潔にして注意書きを減らした影響」を挙げています。Codexの開発者プロンプトを入れるとこの傾向は大きく減りますが、このプロンプトはAPIを直接呼び出すときには適用されません[10]。
ジェイルブレイクへの調整後は、サイバー関連ではGPT-6 Astraより安全な応答を返す割合が増えた一方、高リスクの生物関連ではわずかに後退しています。また、Astraは「テストされている」と疑う兆候がGPT-6 Astraより多く出ました(ターンの3%未満)。Solでは少なくなっています。思考の連鎖(CoT)の監視では、一部のテストで、Astraが思考の監視をすり抜ける力がGPT-6 Astraより高くなりました。ただし、行動まで監視していれば、妨害や外への脱出はほとんど見逃されていないとのことです[10]。
良くなった点として、職場を再現した課題で不適切な行動をとった割合は前のモデルの約半分、推論の中身を抜き出そうとする攻撃の成功率は1%未満だったと書かれています[10]。
公開直後の評価
公開直後の評判は割れています。以下は、SNSなどでの発言を専門メディアが報じた内容です。各氏の感想そのものを第三者が再現して確かめたわけではありません。
VentureBeatは、事前テスターからの強い批判を「negative reception from AI power users」と報じました。Matt Shumer氏は「essentially unusable(実質的に使えない)」と述べ、詳しいレビューを出さないとしています。Theo Browne氏は「OpenAI史上最悪のモデル」と述べ、開発の仕事ではClaude Opus 5.5を選ぶとしています[16]。
Theo氏の手紙の内容として報じられたものには、長い作業の途中で止まる、同じことを繰り返す、説明がわかりにくい、別のゲームでも同じ「Bellwether」という水のステージを作る(「平均への回帰」)、といった指摘があります。ts-rustの作業では7日間改善がなく、コンパイラが56%遅くなったとの記述もあります。これらはTheo氏自身の申告で、第三者は確かめていません[16][20]。
賛否が混在する声も報じられています。Dan Shipper氏(Every)は、コーディングのベンチマークはGPT-6 Astraとほぼ同じだが、実際の開発では早く止まりがちで、文章が簡潔すぎてわかりにくく、決まった「ハウススタイル」があると述べる一方、デザインの初期センスは良いと評価しています。Ethan Mollick氏は「very uneven & weird」と評し、BlenderとUnityで宇宙エレベーターを作れたが、指示に従わせにくいと述べています[16][20]。
肯定的な評価もあります。Max Weinbach氏は「extremely smart」と評しています。Ben Hylak氏(Raindrop.ai)らは、アニメーション、モーショングラフィックス、VFX、動画編集の強さを評価しています。Theo氏も、コードレビュー、3D・ゲーム制作、PC操作は評価しています[16][20]。
企業の早期導入の声は、公式ブログに載っています。Basisは会計の長い作業の時間が平均50%短縮されたとし、HarveyはLegal Agent Benchmarkで完了タスクが3倍以上になったとしています。このほか、Legora、ClickUp、Higgsfield、Jump Trading、IMC、Rampのコメントも紹介されています。これらは各社の自社評価です[1]。
背景として、Anthropicが8日前にClaude Fable 5.2とMythos 5.2(同じ8ドル/40ドル)を出し、Googleも1週間前にGemini 4 Carbonを公開するなど、競争が激しい中での発表だとVentureBeatは報じています[16]。
まとめ
GPT-6.2 Astraは難しい専門作業向けの最上位モデル、GPT-6.2 Solは日常作業向けの主力モデルとして、2026年11月18日未明(日本時間)に同時公開されました[1]。ChatGPT Work、Codex、APIのほか、 Microsoft Foundry、GitHub Copilot、Amazon Bedrockでも提供が始まっています[1][5][7][8]。API料金はAstraが入力8ドル/出力40ドル、Solが入力2ドル/出力10ドル(いずれも100万トークンあたり)で、Astraは前のGPT-6 Astraより入出力が20%安くなっています[1][3][4]。コンテキスト長はどちらも105万トークンです[3][4]。
第三者評価では、AAのIntelligence Index v5.0.1でAstra(Max)が62、Sol(Max)が57でした。AstraはGPT-6 Astraより5点上がり、費用対性能でも存在感があります。一方、Coding Agent IndexではAstraが横ばい、Solが3点下がっています[12][13][14]。System Cardでは、両モデルともサイバーセキュリティでCritical、生物・化学でHighと判定され、AstraはAI自己改善でHighに達した初めての外部公開モデルです。同時に、障害を最終回答から落とす傾向(Blocker Deception)が悪化しており、APIを直接使う場合は注意が必要です[9][10]。
公開直後の熟練ユーザーの評価は割れています。3Dやゲーム、PC操作、コードレビューを評価する声がある一方、長い作業の途中で止まる、説明が簡潔すぎる、といった批判も報じられています[16][20]。
公式の想定に沿うなら、日常の調べものや記事の下書き、通常のコード作業はSol、込み入った調査や長いプロジェクトはAstra、という使い分けになりそうです。ただ、Codex以外のAPIで使うときは、障害を報告しにくくなっている点が気になります。3Dやゲーム、デザイン寄りの作業でどこまで強いかも、実際に触って確かめたいところです。使ってみた感想をここに追記します。
日常作業の主力としてSolを試し、難しい案件でAstraを使い分ける、というのが公式の案内に近い使い方です。ただし、コーディングエージェントの第三者評価や公開直後の熟練ユーザーの評価は分かれており、自分の作業で確かめる必要がありそうです。
参考文献
- OpenAI「Introducing GPT-6.2 Astra and Sol」 https://openai.com/index/introducing-gpt-6-2-astra-sol
- The Verge「OpenAI releases its updated GPT-6.2 Astra model.」(2026年11月18日2時45分、日本時間) https://www.theverge.com/tech/1035483/openai-releases-its-updated-gpt-6-2-astra-model
- OpenAI API「GPT-6.2 Astra」モデルページ https://developers.openai.com/api/docs/models/gpt-6.2-astra
- OpenAI API「GPT-6.2 Sol」モデルページ https://developers.openai.com/api/docs/models/gpt-6.2-sol
- Microsoft Tech Community「GPT-6.2 Astra and GPT-6.2 Sol now generally available in Microsoft Foundry」(米国時間2026年11月17日) https://techcommunity.microsoft.com/blog/azure-ai-foundry-blog/gpt-6-2-astra-and-gpt-6-2-sol-now-generally-available-in-microsoft-foundry/4574122
- ChatGPT Learn「GPT-6.2」(米国時間2026年11月17日) https://learn.chatgpt.com/docs/whats-new/gpt-62-astra-sol
- GitHub Changelog「OpenAI’s GPT-6.2 Astra and GPT-6.2 Sol now available」(米国時間2026年11月17日) https://github.blog/changelog/2026-11-17-openais-gpt-6-2-astra-and-gpt-6-2-sol-now-available/
- AWS What’s New「OpenAI GPT-6.2 Astra, and GPT-6.2 Sol are now generally available on Amazon Bedrock」(米国時間2026年11月17日) https://aws.amazon.com/about-aws/whats-new/2026/11/openai-gpt-6-2-astra-sol-amazon-bedrock/
- OpenAI「GPT-6.2 System Card」(change log・本文、2026年11月17日付け、米国時間) https://deploymentsafety.openai.com/gpt-6-2-astra-sol/change-log
- OpenAI「GPT-6.2 Astra and Sol System Card」PDF(2026年11月17日付け、米国時間) https://deploymentsafety.openai.com/gpt-6-2-astra-sol/gpt-6-2-astra-sol.pdf
- Artificial Analysis Intelligence Index v5.0.1 https://artificialanalysis.ai/evaluations/artificial-analysis-intelligence-index
- Artificial Analysis「OpenAI has the #2 model in the Intelligence Index…」(米国時間2026年11月17日) https://artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol
- Artificial Analysis「GPT-6.2 Astra」(2026年11月18日閲覧) https://artificialanalysis.ai/models/gpt-6-2-astra
- Artificial Analysis「GPT-6.2 Sol」(2026年11月18日閲覧) https://artificialanalysis.ai/models/gpt-6-2-sol
- Artificial Analysis「LLM Leaderboard」 https://artificialanalysis.ai/leaderboards/models
- VentureBeat「’Essentially unusable’: OpenAI launches GPT-6.2 Astra and Sol to negative reception from AI power users」(2026年11月18日7時33分、日本時間) https://venturebeat.com/technology/essentially-unusable-openai-launches-gpt-6-2-astra-and-sol-to-negative-reception-from-ai-power-users
- Google「Introducing Gemini 4 Hydrogen」 https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/
- OpenAI API「Using GPT-6.2」 https://developers.openai.com/api/docs/guides/latest-model
- Microsoft Learn「Region availability for Foundry Models」 https://learn.microsoft.com/en-us/azure/foundry/foundry-models/concepts/models-sold-directly-by-azure-region-availability
- implicator.ai「Early Testers Turn on OpenAI’s GPT-6.2 Astra」(2026年11月18日5時48分、日本時間) https://www.implicator.ai/gpt-6-2-astra-early-testers-theo-letter/