概要
深層学習(ディープラーニング)は、人工知能(AI)技術の発展を支える根幹の一つであり、近年の技術革新によって急速に進化しています。本記事では、深層学習の概要、仕組み、そしてその発展の歴史を詳細に解説します。
機械学習
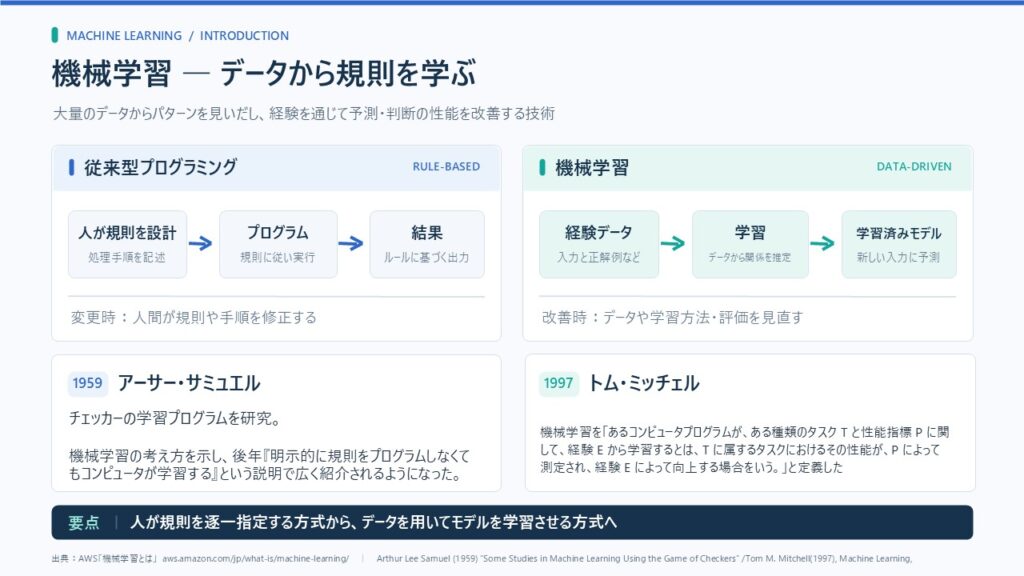
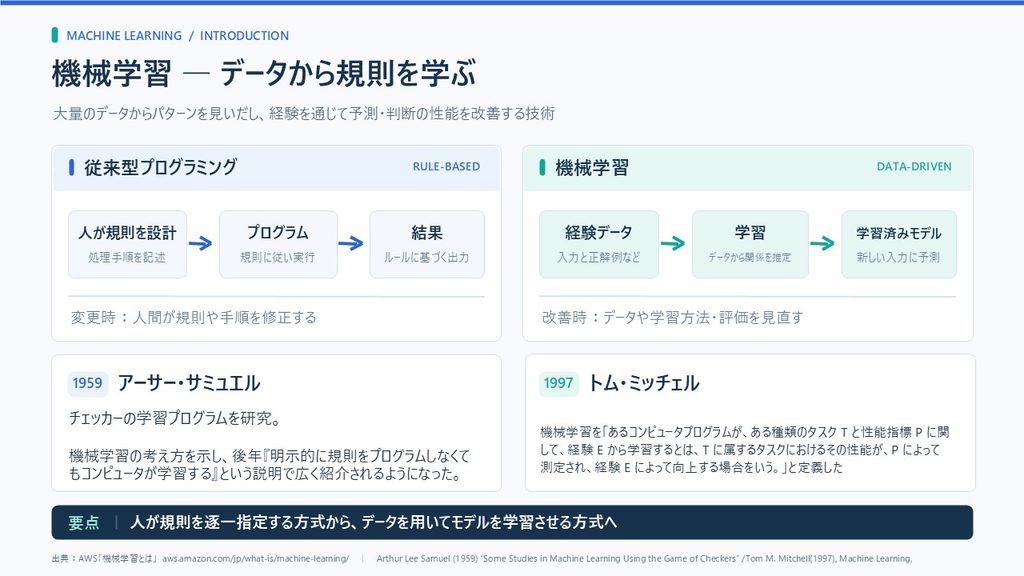
「機械学習は、コンピュータシステムが明示的な指示なしにタスクを実行するために使用するアルゴリズムと統計モデルを開発する科学であり、代わりにパターンと推論を利用します。コンピュータシステムは、機械学習アルゴリズムを使用して、大量の履歴データを処理し、データパターンを識別します。」(AWS,” 機械学習とは”, https://aws.amazon.com/jp/what-is/machine-learning/)
アーサー・リー・サミュエル(Arthur Lee Samuel)は、アメリカの計算機科学者であり、コンピュータゲームや人工知能の分野で主に知られています。彼は、世界初の学習型のプログラムであるコンピュータチェッカーを開発し、人工知能の基本的概念を確立しました。
サミュエルは1959年に「機械学習(Machine Learning)」という言葉を広めた人物として知られています。彼は機械学習を「明示的にプログラムしなくても学習する能力をコンピュータに与える研究分野(Field of study that gives computers the ability to learn without being explicitly programmed)」と定義しました。 彼のチェッカープログラムは、コンピュータに自己学習能力を持たせる試みとして、人工知能の発展に大きく寄与しました。
“Some Studies in Machine Learning Using the Game of Checkers”

またトム・ミッチェルは1997年に機械学習を「あるコンピュータプログラムが、ある種類のタスク T と性能指標 P に関して、経験 E から学習するとは、T に属するタスクにおけるその性能が、P によって測定され、経験 E によって向上する場合をいう。(A computer program is said to learn from experience E with respect to some class of tasks T and performance measure P, if its performance at tasks in T, as measured by P, improves with experience E.)」(Tom M. Mitchell(1997),”Machine Learning”, McGraw-Hill,3P)と定義し、機械学習を「経験を通じて自動的に改善するコンピュータアルゴリズムの研究」と説明されています。
Tom M. Mitchell(1997),”Machine Learning”, McGraw-Hill
機械学習は従来のプログラミングの概念を根本的に変えることになりました。従来型のプログラムでは、人間がすべてのルールを明示的に記述する必要がありましたが、機械学習ではコンピュータが大量のデータの中から自律的にルールや知識を学習することになります。これにより、コンピュータは新たな課題に対しても柔軟かつ高度な処理能力を獲得し、複雑な問題にも対応できるようになりました。
機械学習以前は、人間が定義したルールに基づくシステムが主流でした。これらのシステムは特定のタスクには効果的でしたが、新しい状況への適応性に欠けていました。機械学習はこの制限を克服するために発展してきました。
機械学習の手法として
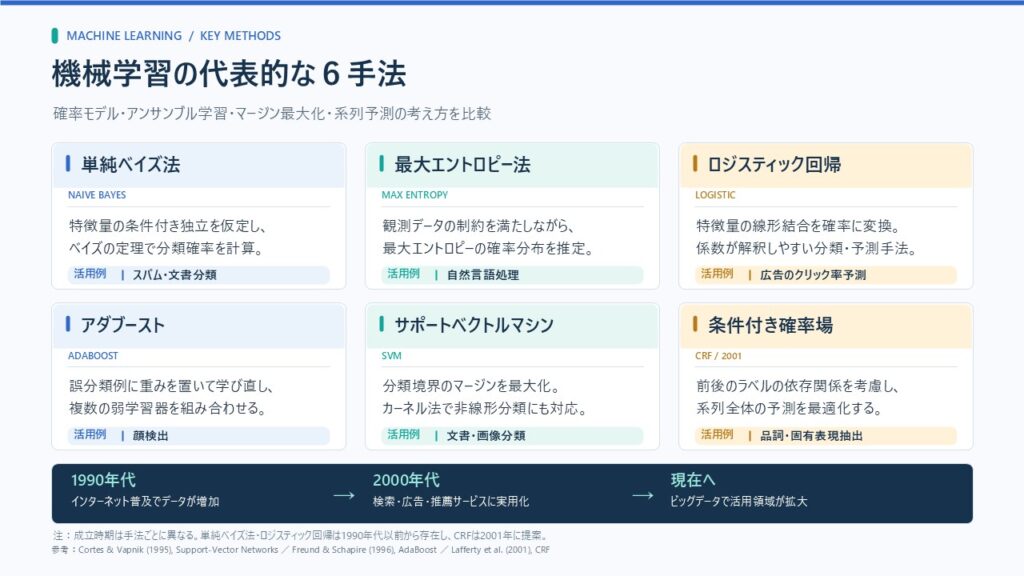
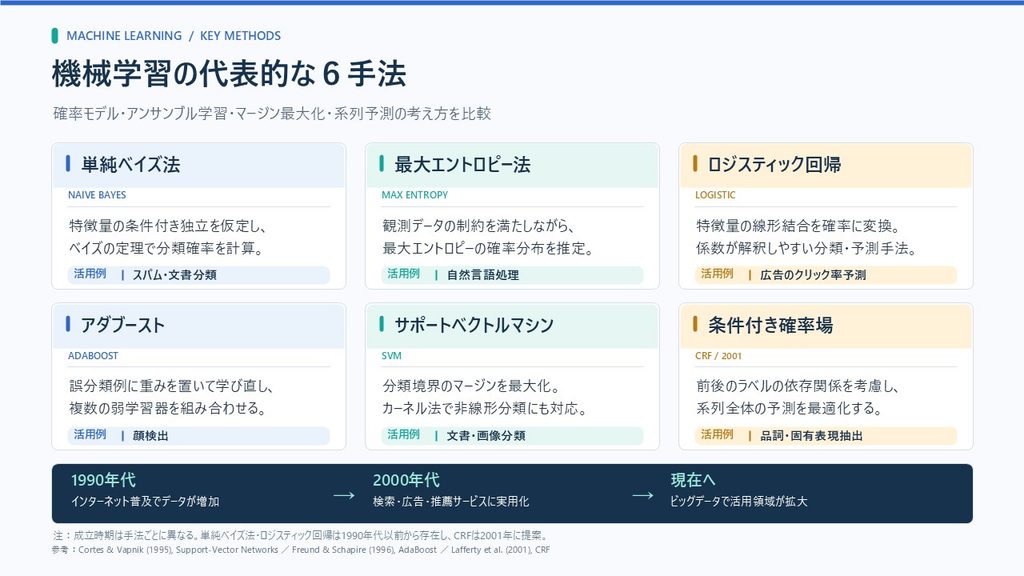
1990年代後半から生まれたものとして
- 単純ベイズ法/ナイーブベイズ法
確率ベースの分類器です。単純ベイズ法は、入力の特徴同士が条件付き独立であるという仮定を置き、ベイズの定理だけでクラス分類を行う極めてシンプルな確率モデルです。1990年代のスパムフィルタやニュース分類で再評価され、各クラスの事前確率と条件付き確率を単純な頻度計算だけで推定できるため、学習も推論も線形時間で済む軽量さが特徴です。独立仮定が実際には破綻している場合も多いものの、少量データや高次元疎データに対しては意外なほど健闘し、現在でも高速ベースラインとして重宝されています。
- 最大エントロピー法
最大エントロピー法は「制約(特徴量の出現期待値など)以外の情報を入れない」という最大エントロピー原理に基づき、観測データと一致する条件を満たす確率分布の中でエントロピー(情報量の尺度、期待値)が最大のモデルを選択します。結果として指数族の確率分布が得られ、任意の特徴関数を足し込める柔軟性が自然言語処理の諸タスクで威力を発揮しました。対数尤度最大化は凸最適化ですが反復計算が重く、当時の計算資源ではコストが高かったものの、「仮定を最小化する統計モデリング」という発想を普及させた意義は大きいと言えます。
- ロジスティック回帰モデル
ロジスティック回帰は対数線形モデルを用いた確率モデルです。線形結合をシグモイド(あるいは多クラスではソフトマックス)に通して確率解釈を与える古典的モデルで、1990年代後半にオンライン広告のクリック率予測など産業界で脚光を浴びました。対数尤度最大化は凸問題であり、確率的勾配降下により大規模データにも適用しやすく、得られる重みはそのまま特徴の寄与度を示すため可読性にも優れます。一方で線形分離を前提とするため、高度な非線形関係を捉えるにはカーネル化や特徴エンジニアリングが必須です。
- アダブースト
アダブーストは弱学習器を組み合わせて強い分類器を作る手法です。「誤り率が 0.5 未満であればどんな弱学習器でも良い」という考え方で、それらを多数束ねて誤りを指数的に低減させるブースティング手法です。各ラウンドで誤分類サンプルに重みを寄せて弱学習器を再学習し、最終的には重み付き多数決で決定を下します。顔検出アルゴリズムが象徴するように、軽量な決定を積み重ねても強力な分類性能が得られる一方、外れ値やクラス不均衡には敏感で、重みが極端に偏ると性能が不安定になる点には注意が要ります。
- サポートベクトルマシン
サポートベクトルマシンは「マージン最大化」という幾何学的基準で決定境界を決める理論的に洗練された分類器です。線形 SVM では二次計画問題を解くことで最大マージン原理に基づき超平面を求め、カーネル法を組み合わせることで非線形分離も可能になります。少量データでも頑健に汎化し、高次元でも「サポートベクトル」のみに依存するためモデルが比較的コンパクトですが、ハイパーパラメータ(C、カーネル幅)のチューニングが成否を大きく左右し、大規模データでは計算量が課題となります。
- 条件付き確率場
条件付き確率場は、系列全体のラベル集合に対する条件付き確率を直接モデル化し、ラベル間の相互依存性と豊富な入力特徴を同時に扱える点で、隠れマルコフモデルの限界を乗り越えました。前向き後向きアルゴリズムで正規化定数を計算しながら対数尤度を最適化するため計算コストは高いものの、品詞タグ付けや名前付き実体認識などラベル間の整合性が重要なタスクでは高精度を実現し、深層ネットワーク時代には BiLSTM-CRF という形で依然として活用されています。
1990年代以降のインターネットの普及により大量のデータが蓄積されるようになり、2000年代に入るとGoogle検索システムや検索連動型広告、Amazonの推薦システムなど機械学習によるサービスが生まれます。そして「ビッグデータ」という概念が登場しました。機械学習はこの膨大なデータを活用することで飛躍的な進歩を遂げ、従来では処理できなかった複雑なパターン認識や高度な予測が可能になりました。現在では、機械学習は様々な分野で広く活用されています。
特徴量
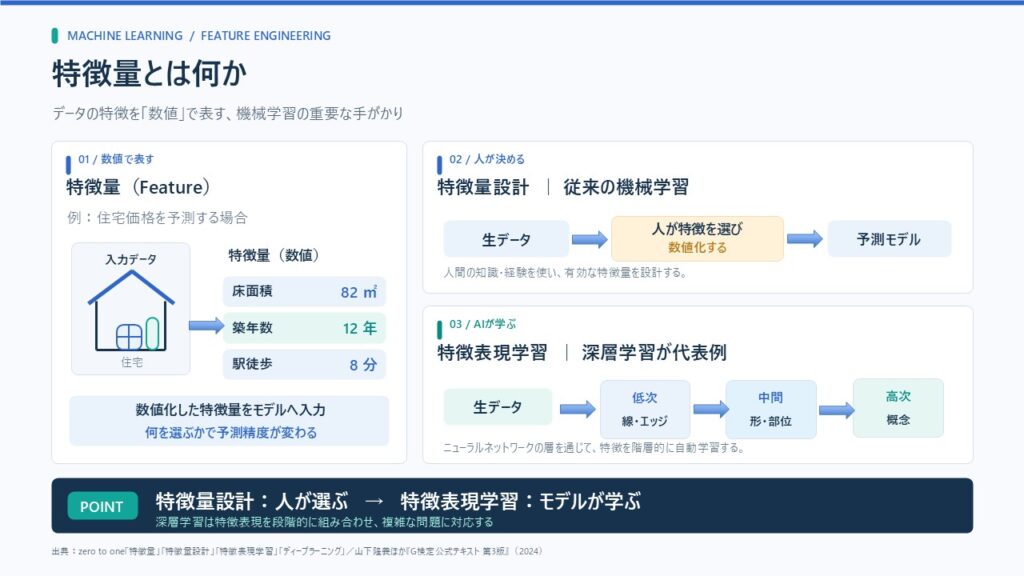
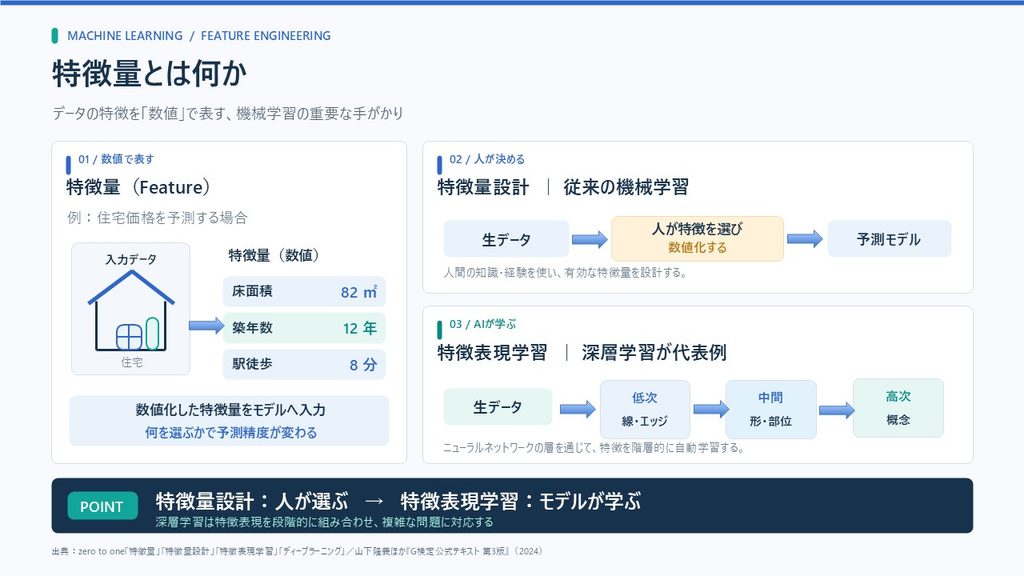
機械学習において、対象となるデータの特徴を定量的に表したものを、特徴量と呼びます。(zero to one, 特徴量)。モデルの性能は、この特徴量の選択によって大きく左右されます。従来の機械学習は与えられた特徴量を利用するだけであり、どの特徴量を選択するかは基本的に人間が決定します。これをいわゆる「特徴量設計」と呼びます。特徴量設計とはデータが持つ特徴をコンピュータが理解できるように数値化することです。人工知能の歴史において、従来は人間が特徴量設計を行っていました。(zero to one, 特徴量設計)。そのため、人間による適切な特徴量の選択は人工知能の機械学習において非常に重要な役割を果たしていました。
また、人間が適切な特徴量を見つけ出すことが難しい複雑な問題に対して、人工知能自身に特徴量を発見させるアプローチが開発されました。これを特徴表現学習と呼びます。特徴表現学習とは、本来人の手で見つけ出すのが難しい特徴量を機械学習自体に発見させるアプローチです。(zero to one,特徴表現学習)。機械学習の中でも、特徴量(対象の特徴を定量的に表したもの)を人工知能が自ら学習するものをディープラーニングと呼びます。(zero to one,ディープラーニング)。ディープラーニングと呼ばれるこの手法では、アルゴリズムが大量のデータから意味のある特徴量を自動的に抽出することを目指します。
また、この「特徴表現学習」を行う機械学習アルゴリズムの1つをディープラーニング(深層学習)といいます。(zero to one,特徴表現学習)。ディープラーニングは、与えられたデータの特徴量を階層化し、それらを組み合わせることで問題を解きます。(山下隆義他,深層学習教科書ディープラーニングG検定(ジェネラリスト)公式テキスト第3版,2025年1月15日,株式会社翔泳社)。
ディープラーニングを別の視点から捉えると、ニューラルネットワークは複数の処理ステップから成るコンピュータプログラムそのものを学習できるという特性があります。ネットワークの各層を「コンピュータの処理ステップ」と見なせば、層が深くなるほど、より多くのステップを含むプログラムを表現できることになります。与えられた問題を解くために必要な処理(プログラム)に役立つ情報が特徴量として抽出されていると考えることができるわけです。(山下隆義他,深層学習教科書ディープラーニングG検定(ジェネラリスト)公式テキスト第3版,2025年1月15日,株式会社翔泳社)。これにより各層の処理結果を次の層が利用することで、複雑なタスクを分解して解決でき、深いネットワークになるほど、より高度な概念や推論を表現可能になります
このように、ニューラルネットワークは単なる特徴抽出器としてだけでなく、複雑な関数やプログラムを学習する能力も備えています。
次の項目ではこの深層学習(ディープラーニング)について詳細に見ていきます。
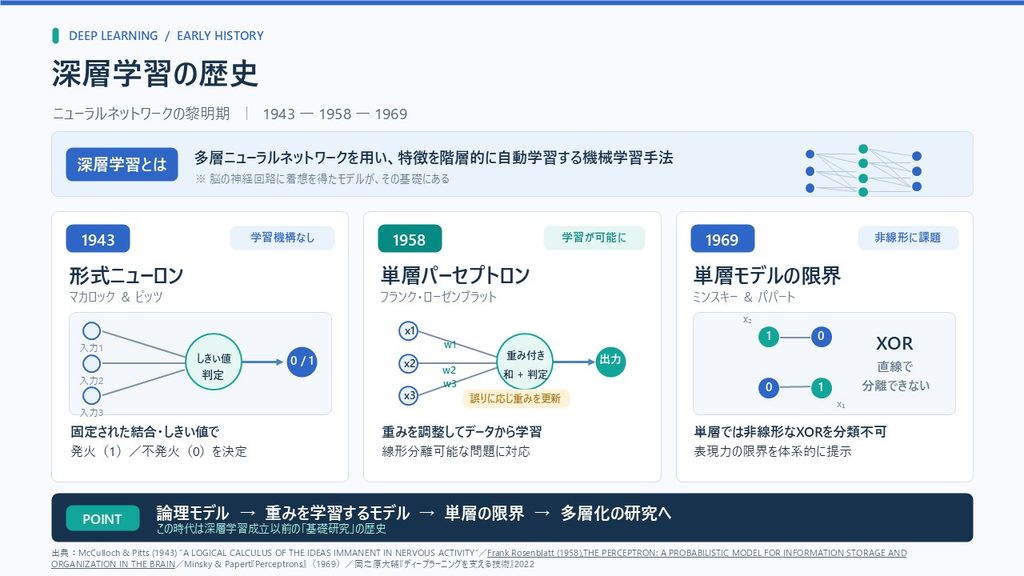
深層学習(ディープラーニング)の歴史
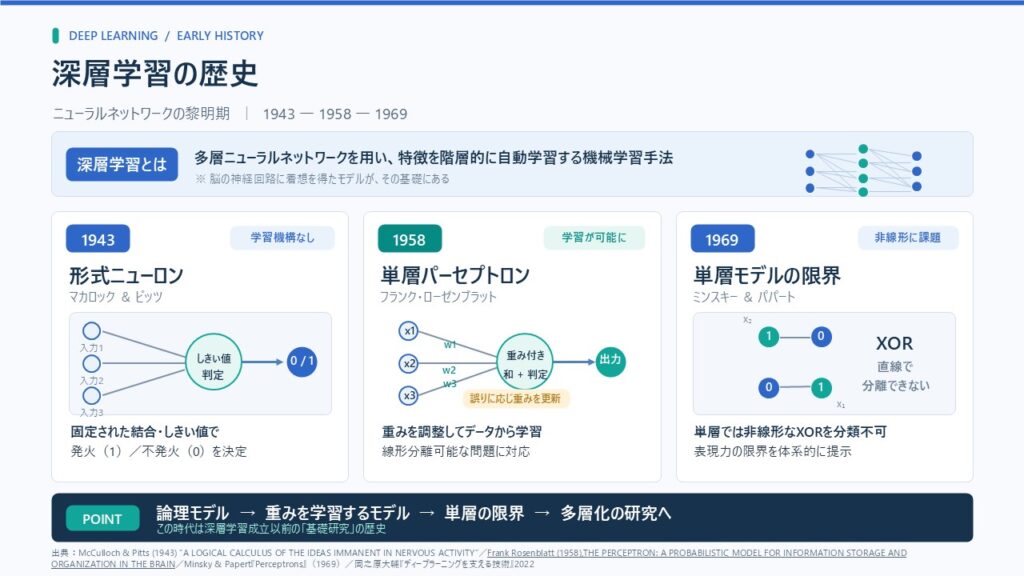
深層学習(ディープラーニング)とは、人間の神経細胞を元にした多層の人工ニューラルネットワークを用いてデータを学習し、特徴を自動抽出・解析する機械学習の一手法です。ディープラーニングは層の数が多く、幅が広い、ニューラルネットワークを利用した機械学習手法、またそれらに関連する研究領域です。(岡之原大輔,ディープラーニングを支える技術 「正解」を導くアルゴリズム,技術評論社,212頁)。従来の機械学習では、特徴量設計を人間の手作業で行う必要がありましたが、深層学習は大量のデータを学習することで自動的に適切な特徴を抽出し、高い精度の予測や認識を可能にします。
ニューラルネットワーク
ニューラルネットワークとは、生物の神経回路を模倣して設計された機械学習の手法です。ニューラルネットワークは、もともとは脳のしくみを模して造られました。ニューラルネットワークもニューロンとそれをつなぐシナプスから成る重み(パラメータ)から構成されます。 (岡之原大輔,ディープラーニングを支える技術 「正解」を導くアルゴリズム,技術評論社,213頁)。ニューラルネットワークは複雑なパターン認識や分類問題を解決するために広く用いられており、現代の人工知能技術の中核を担っています。その仕組みは人間の脳内にある神経細胞(ニューロン)とシナプスと呼ばれるニューロンの接合部位のネットワーク構造に着想を得ています。
形式ニューロン
1943年、神経生理学者のウォーレン・マカロックと数学者のウォルター・ピッツは生物の神経細胞の働きを単純化した「形式ニューロンモデル」を発表しました。形式ニューロンモデルはニューロンの状態を0/1(不発火/発火)で表し、興奮・抑制入力と閾値で発火が決まる全か無か(all-or-none)のしきい値論理として定式化しています。このモデルは入力信号を処理し、一定の閾値を超えた場合にのみ出力するという単純な仕組みでした。しかし、この初期モデルには重要な制限がありました
それはこの形式ニューロンは学習機能を持たなかったことです。「結合と閾値が変化しない仮想ネット」に置き換えて議論できると明言しており、モデル自体に重み更新を組み込んでいません。そのためにこの形式ニューロンには与えられたルールに従って決まった振る舞いをするだけで新しい情報に適応する能力がありませんでした。それは固定された結合・閾値・更新規則に基づく自動機械(オートマトン)として理解され、外界からの新情報で内部パラメータを更新する仕組みは持ちません。
McCulloch & Pitts (1943) ”A LOGICAL CALCULUS OF THE IDEAS IMMANENT IN NERVOUS ACTIVITY”
単層パーセプトロン
1958年、米国の心理学者フランク・ローゼンブラットが画期的な進歩をもたらす「パーセプトロン」を提案しました。パーセプトロンは学習能力を持つ初めてのニューロンモデルです。
パーセプトロンは複数の入力 に対して各々重み
を割り当て、重み付き和を計算し、しきい値関数で出力を決定します。この重みは学習プロセスで調整されます。そして、重みの調整によって、データから学習することが可能であります。
またパーセプトロンは線形に分離可能な分類問題(例:○と×を分ける問題)を解くことができます
この革新的なモデルにより「概念形成」や「学習する機械への希望」に対する期待が高まり、第1次ニューラルネットワークブームが始まりました。
単層パーセプトロンの限界
しかし、1969年にマービン・ミンスキーとシーモア・パパートの著書『Perceptrons: An Introduction to Computational Geometry』(1969)によって、パーセプトロンの重大な限界が明らかになりました
単層パーセプトロンは線形分離可能な問題しか解けません。(XORやパリティ、連結性などの重要な述語には対応不可)。これは単層パーセプトロンが“単一の重み付き和+しきい値”という構造ゆえに超平面で分けられない(非線形分離)パターンを分離できないためです。そのため1層の線形判別(超平面)は分けられないため、単層のパーセプトロンでは複雑なデータの分類が不可能です。
この研究結果により、ニューラルネットワークへの期待は急速に縮小し、それに伴い研究費用の縮小が起き、研究は一時的に停滞しました。1940年代から1960年代初期にかけての期間はニューラルネットワーク研究の第1次ブームとして歴史に記録され、1970年代に失速という流れになります。
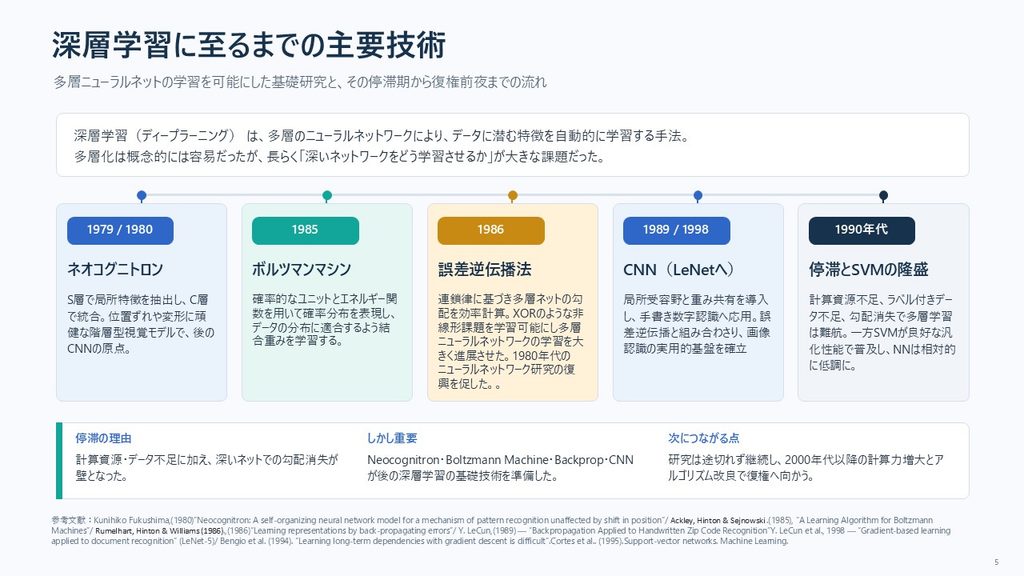
深層学習(ディープラーニング)
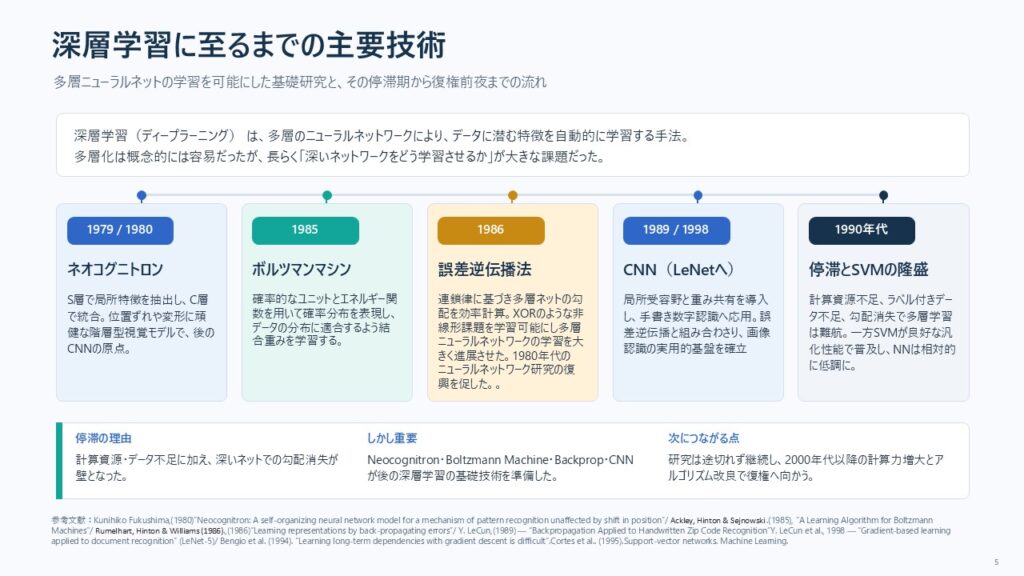
深層学習(ディープラーニング)とは、多層のニューラルネットワークを用いてデータに潜む特徴を自動的に学習する機械学習の手法です。従来のニューラルネットワークと異なり、多層構造を活用することで、より複雑なパターンを学習することが可能になります。この技術は現代のAI革命の中核となり、画像認識、自然言語処理、音声認識など多岐にわたる分野で革新的な成果をもたらしています。ニューラルネットワークを多層化すること自体は概念的には簡単ですが、深層のネットワーク全体を効果的に学習させる方法は長らく課題でした。
ネオコグニトロン
1979年、日本の福島邦彦が視覚系の神経回路を模倣した「ネオコグニトロン」を発表しました。ネオコグニトロンは、生物視覚系を模倣した階層型多層ニューラルネットワークです。ネットワークは順次重ねられた「S層(S‑cells)」と「C層(C‑cells)」という構成で、S層で局所的な特徴を抽出し、C層がそれらを統合しながら位置ずれや変形に対して頑健な認識を実現します。現在の畳み込みニューラルネットワーク(CNN)に大きな影響を与えた画期的な研究でした。論文は1980年に学術誌に掲載されています。
ボルツマシン
ボルツマンマシンとは、多数の二値ユニットが相互に結合した確率的なニューラルネットワークです。1985年のAckley、Hinton、Sejnowski の論文では、このモデルは外界から与えられた事例の背後にある制約や規則性を学習し、部分的な入力から全体の解釈や欠損部分の補完を行うものとして説明されています。
各二値ユニットは、観測された特徴や潜在的な状態を表します。ユニット間の重みは、それらの状態同士の相性を表し、正の重みは互いに支持し合う関係、負の重みは同時に成り立ちにくい関係を意味します。ネットワーク全体の状態にはエネルギーが定義され、エネルギーが低いほど制約をよく満たした状態とみなされます。ボルツマンマシンは、ユニットの状態を確率的に変化させることで、局所的な解に閉じ込められにくくしながら、低エネルギー状態を探索します。
学習では、データを与えて可視ユニットを固定したときのユニット同士の共起と、ネットワークを自由に動かしたときの共起との差に基づいて重みを更新します。これにより、訓練データの確率分布に近づくように内部モデルが調整され、未知の入力や欠損した情報に対しても妥当な補完を行えるようになります。
Ackley, Hinton, Sejnowski (1985), “A Learning Algorithm for Boltzmann Machines”
誤差逆伝播法(バックプロパゲーション)
1986年にラメンハートらは多層ニューラルネットにおける誤差の連鎖律に基づく効率的な勾配計算である誤差逆伝播法(バックプロパゲーション)を定式化することによって、単層パーセプトロンでは解けなかったXOR を含む非線形課題や表現学習が単純な局所学習則の拡張で達成できることを実証しました。これにより1960年代末のパーセプトロン批判後に停滞していた「多層学習」の実用的道筋が開け、以後の深層学習の原型が確立しました。
ラメルハートらの多層パーセプトロンと誤差逆伝播法の提案により、ニューラルネットワークの多層化が実用的なものとなり、第2次ニューラルネットワークブームが到来しました。これにより、ニューラルネットワークはより複雑な問題を解決できる可能性が大きく広がりました。
畳み込みニューラルネットワーク(CNN)
その後(1989年)、ヤン・ルカンは誤差逆伝播を用いて郵便番号の手書き数字認識に畳み込み的な構造(局所受容野・重み共有)を導入し、ネットワークが画像の特徴(フィルタ)を自動で学習できることを示しました。これらの成果は後に LeNet(代表的には LeNet-5, 1998年)として整理され、CNN が実用的な画像認識手法として確立する礎になりました。
Y. LeCun,(1989) — “Backpropagation Applied to Handwritten Zip Code Recognition”
ニューラルネットワークの低調とサポートベクターマシン(SVM)の隆盛
1990年代には、当時の計算資源とラベル付きデータの不足、ならびに多層・長期依存の学習で生じる勾配消失などの学術的課題により、多層ニューラルネットの実用化が難航しました。そのため多くの応用分野では理論的に良好な汎化性能を示したサポートベクターマシン(SVM)などの手法が採用され、ニューラルネットは相対的に低調な時期を迎えました(ただし研究自体は継続しており、後の計算力増大とアルゴリズム革新で復権することになります)。
Cortes, C,Vapnik, V. (1995). Support-vector networks. Machine Learning.
この間にもニューラルネットワークの可能性を信じて研究を続けた科学者たちにより、いくつかの重要なブレイクスルーが実現しました
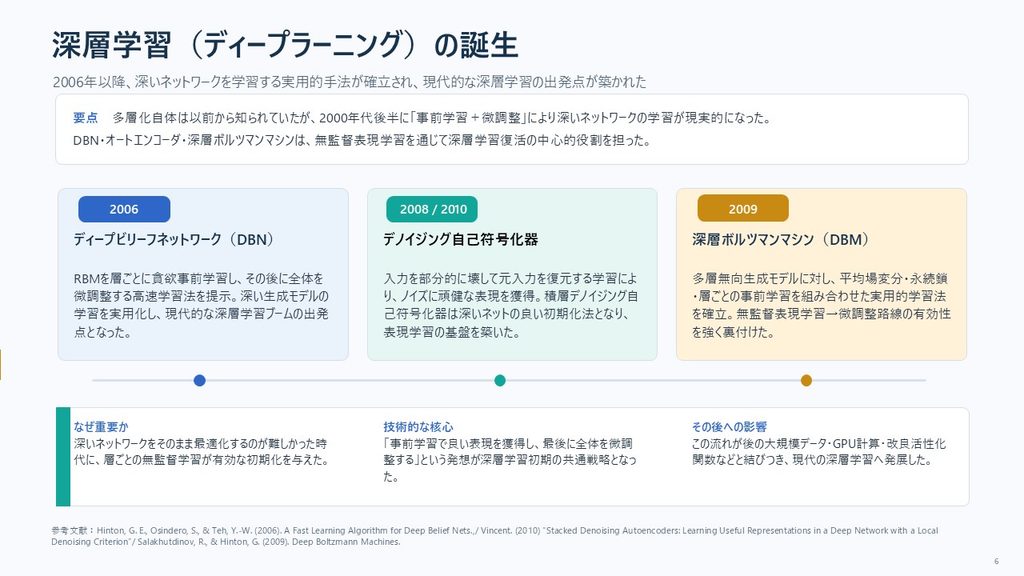
深層学習(ディープラーニング)の誕生
2006年、ジェフリー・ヒントンらは深層生成モデルを一層ずつ学習し、その後に全体を微調整するための高速アルゴリズムを提示しました。層ごとに上位2層を無向の制限付きボルツマンマシン(RBM)とし、それより下を有向の生成モデルとして重ねるディープビリーフネットワーク(DBN)の枠組みで、補完的事前分布により「説明消去」を回避し、層ごとに貪欲に表現を変換しながら改善が保証される学習を行いました。そしてこれをディープラーニングと名付けます。(深層学習)
Hinton, G.E, Osindero, S,Teh, Y.-W. (2006) “A fast learning algorithm for deep belief nets”,
デノイジング自己符号化器(オートエンコーダ)
2008 年のビンセントらの論文によって示されたデノイジング自己符号化器(オートエンコーダ)は、入力を部分破損させて元の入力を復元する訓練により、ノイズに頑健で多様体に沿った表現を学習します。これを層ごとに積み重ねると深いネットワークの初期化として有効で、多数のベンチマークで自己符号化の積層や RBM 系を上回る汎化性能を示しました。のちの理論は、デノイジング自己符号化器(オートエンコーダ)がデータ分布のスコアを局所的に学ぶことを示し、表現学習の基盤として歴史的に重要な役割を果たしました。
深層ボルツマシン
深層ボルツマシン(2009)は,平均場変分でデータ依存統計を,永続鎖でモデル統計を推定するハイブリッド学習と,深層ボルツマシンに整合した層ごと事前学習,さらにAISによる分配関数推定を組み合わせることで,多層無向生成モデルの実用的学習・評価を初めて確立した。良好な生成・識別結果は,無監督表現から微調整という当時の深層学習路線を強固に裏付けました。
Salakhutdinov, R. & Hinton, G. (2009). “Deep Boltzmann Machines”,
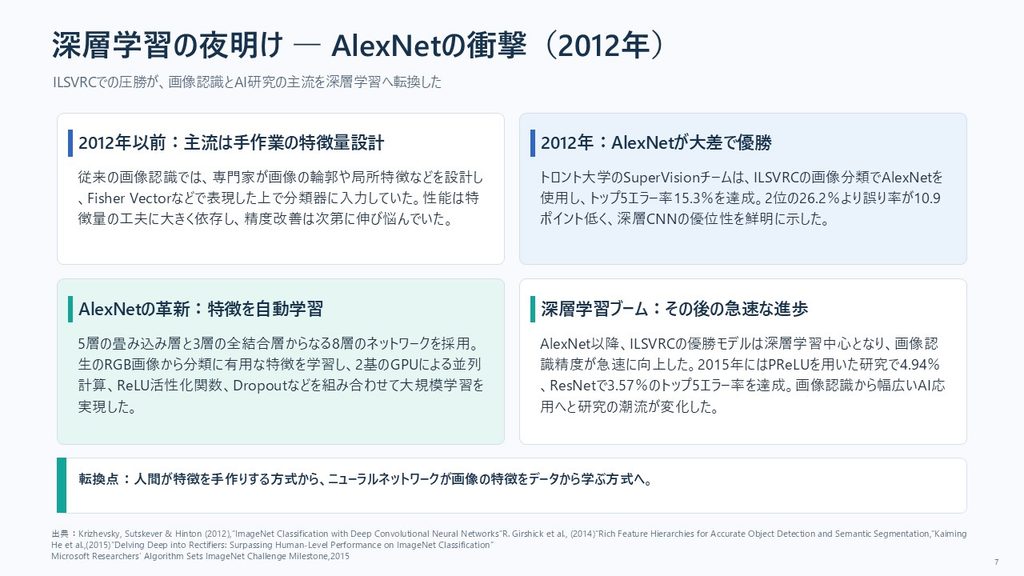
深層学習(ディープラーニング)の夜明け
AlexNet
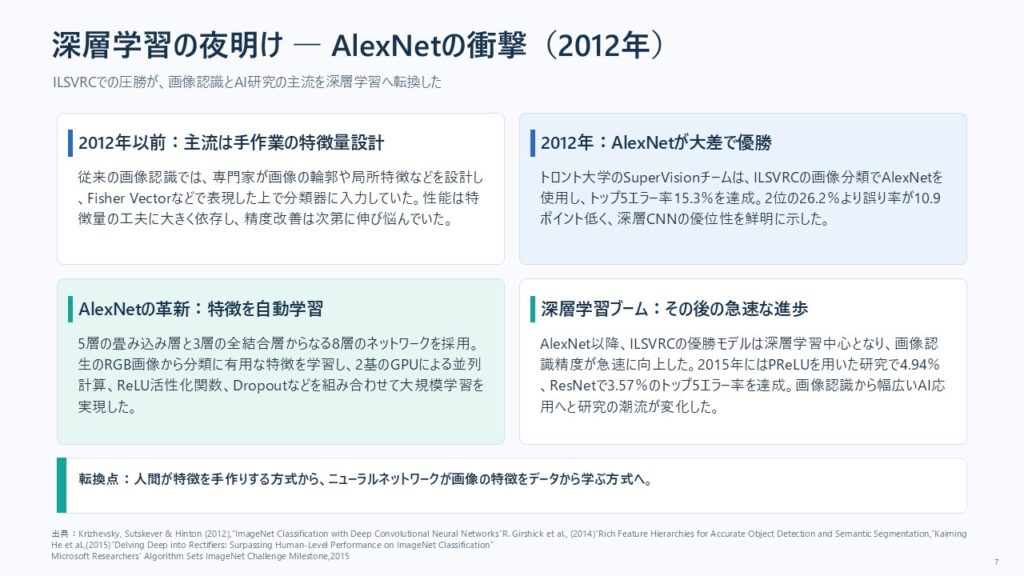
2012年、画像認識の精度を競う国際的な競技会ILSVRC(ImageNet Large Scale Visual Recognition Challenge)において、トロント大学のジェフリー・ヒントン教授率いるチーム「SuperVision」が圧倒的な勝利を収めました。ILSVRCは、コンピュータが画像内の対象物を正確に識別する能力を競う大会であり、エラー率(誤認識の割合)の低さが評価の指標となります。この競技では、AlexNet と呼ばれる深層畳み込みニューラルネットワークによりトップ5のエラー率 15.3% を達成し、従来法に対して大差で優勝しました。
2012年以前から機械学習を用いた画像認識はすでに一般的でしたが、モデルの性能は「特徴量」の設計に大きく依存していました。この特徴量の選定は人間の専門家の手に委ねられ、高度な専門知識が求められるものでした。こうした手法による改善は徐々に限界を迎えつつあり、ILSVRCのエラー率は2010年の28%から2011年には26%へと、わずかな改善しか見られない状況でした。画像認識技術は停滞期に入りつつあるように思われていました。
このような停滞の状況の中、2012 年の ILSVRC において,トロント大学の SuperVision チームが提案した 『AlexNet』 は トップ5エラー率 15.3% を達成し,2 位である東京大学 ISI チームの Fisher Vector ベース手法(約 26%)を 10 ポイント以上上回る成績で画像分類タスクを制した。この大差は,当時主流であった手作り特徴量設計+Fisher Vector+線形分類器といったパイプラインが支配的だった ILSVRC において、深層畳み込みニューラルネットワークがもたらしたブレイクスルーとして受け止められ。AlexNet は 5 層の畳み込み層と 3 層の全結合層から成る 8 層の深いネットワークであり,生の RGB 画素値から特徴表現を学習し,2 枚の GPU 上で並列学習する構成を採用することで,従来手法を大きく上回る精度を実現しました。
ディープラーニングの研究自体は2006年ごろからジェフリー・ヒントンらによって推進されていましたが、この技術が実際に画像認識の分野で既存の機械学習手法を圧倒的に凌駕できることを実証したのが、2012年のILSVRCだったのです。
この歴史的なブレイクスルー以降、ILSVRC の画像分類タスクの優勝モデルはいずれもこのディープラーニングに基づくものとなり,ネットワークをより深くしつつ新たな手法を組み合わせることで、エラー率は急速に低下していきました。
2015 年にはマイクロソフトの PReLUがトップ5エラー率 4.94% を達成し,人間の誤り率とされる約 5.1% を初めて下回り、同年の ResNet は 3.57% という精度で ILSVRC を制しました。こうした一連の成果は,単に画像認識の精度を向上させただけでなく、コンピュータビジョンおよび人工知能研究全体の潮流をディープラーニング中心へと大きく転換させ、現在の AI革命(自動運転,医療画像診断,顔認識など)を支える基盤技術となっています。
Microsoft Researchers’ Algorithm Sets ImageNet Challenge Milestone,2014
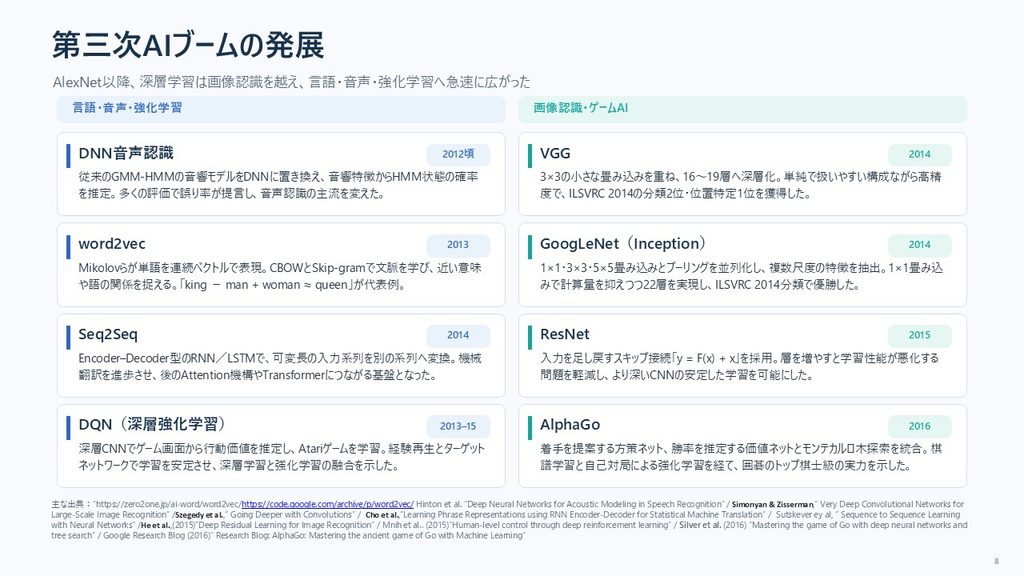
第三次AIブームの発展
word2vec
word2vec は、Google の Mikolov らが開発した 単語を数値ベクトルで表現する手法です。大量のテキストを学習し、似た文脈で使われる単語ほど近い位置に配置される分散表現を生成します。モデルには、周辺語から中心語を予測する CBOW と、中心語から周辺語を予測する Skip-gram の2種類があります。また、Negative Sampling や Hierarchical Softmax により大規模データでも高速に学習できます。得られたベクトルは、類義語検索、文章分類、機械翻訳、推薦など多くの自然言語処理タスクで利用され、「king − man + woman ≈ queen」といった意味的関係の演算が可能な点でも注目されました。


DNN音声認識
DNN音声認識は、従来の GMM-HMM 音声認識で「音の見た目」を評価していた GMM を、多層のディープニューラルネット(DNN)に置き換えた音響モデルを指します。HMM が時間的変動(発音の伸び縮み)を扱い、DNN は複数フレームの音響特徴量を入力として各 HMM 状態の 事後確率を直接出力します。Hinton らの総説では、この DNN 音響モデルが TIMIT や大語彙連続音声認識など多くのベンチマークで、従来の GMM 音響モデルよりもしばしば 相対 20〜30% 程度の誤り率削減を達成し、新しい標準手法になったと報告されています。
Geoffrey Hinton, Li Deng, Dong Yu, George Dahl, Abdel-rahman Mohamed, Navdeep Jaitly, Andrew Senior, Vincent Vanhoucke, Patrick Nguyen, Tara Sainath, and Brian Kingsbury “Deep Neural Networks for Acoustic Modeling in Speech Recognition”
https://static.googleusercontent.com/media/research.google.com/ja//pubs/archive/38131.pdf
VGG
VGGはオックスフォード大学の Visual Geometry Group(VGG) によって提案された、画像認識向けの深い畳み込みニューラルネットワーク(CNN)の系列です。ImageNetを用いて,3×3の小さな畳み込みフィルタのみを用い,それを多数積み重ねて16〜19層(VGG-16/19)のネットを構成し,深さと精度の関係を系統的に評価しました。その結果,従来より大幅に精度が向上し,ILSVRC 2014で分類2位・位置特定1位を獲得しています。構造は「3×3畳み込み×数回+2×2プーリング」を繰り返し,最後に全結合層とsoftmaxを置くという非常に単純な設計であり,このシンプルさと高性能により,後続のResNetや各種検出・スタイル変換の標準バックボーンとして広く用いられました。

Karen Simonyan, Andrew Zisserman” Very Deep Convolutional Networks for Large-Scale Image Recognition”

GoogLeNet
GoogLeNet は,Szegedy らの論文「Going Deeper with Convolutions」で提案された Inception アーキテクチャの代表的実装であり,ImageNet ILSVRC 2014 の分類タスクで Top-5 error 6.67%を達成し優勝した 22 層の深い CNN です。計算コストをほとんど増やさずにネットワークの「深さ」と「幅」を同時に拡大し,GPU 資源を効率良く使う設計を示すことにあります。その中核となる Inception モジュールでは,1×1・3×3・5×5 畳み込みとプーリングを並列に適用し,出力をチャネル方向に結合することで,ひとつの層の中でマルチスケールな特徴を抽出します。また,1×1 畳み込みを前置してチャネル数を削減し,パラメータ数と演算量を抑える工夫が導入されています。さらに学習を安定させるため,中間層に小さな補助分類器を配置する点も特徴です。

Christian Szegedy, Wei Liu, Yangqing Jia, Pierre Sermanet, Scott Reed, Dragomir Anguelov, Dumitru Erhan, Vincent Vanhoucke, Andrew Rabinovich” Going Deeper with Convolutions”

Seq2Seq
Seq2Seq(sequence-to-sequence)モデルは,可変長の入力系列を別の可変長系列へ直接写像するためのニューラルネット枠組みです。キョンヒュン・チョらは「RNN Encoder–Decoder」モデルとして,1つ目のRNNがソース系列を読み込み固定長ベクトルへエンコードし,2つ目のRNNがそのベクトルからターゲット系列を逐次生成して条件付き確率を学習する方法を提案しました。
その後イリヤ・サツケバーらは,多層LSTMを用いた一般的なSeq2Seq学習法を示し,英仏翻訳WMT’14で従来のフレーズベース機械翻訳と同等以上のBLEUを達成し,さらにN-bestリランキングで 36.5 BLEU に到達したと報告しています。この「エンコーダで系列全体をベクトル化し,デコーダで新しい系列へ展開する」という構造が,のちのAttention付きSeq2SeqやTransformerなど,翻訳・要約・対話・音声認識など多くの生成タスクの基本形となりました。

Kyunghyun Cho, Bart van Merrienboer, Caglar Gulcehre, Dzmitry Bahdanau, Fethi Bougares, Holger Schwenk, Yoshua Bengio”Learning Phrase Representations using RNN Encoder-Decoder for Statistical Machine Translation”

Ilya Sutskever, Oriol Vinyals, Quoc V. Le” Sequence to Sequence Learning with Neural Networks”

ResNet
ResNet(Residual Network)は、「残差学習」の枠組みに基づく深層CNNです。深い層のCNNで起きやすい「層を増やすと訓練誤差まで悪化する(性能劣化問題)」を解決するために提案された手法です。各ブロックが目的の写像H(x)を直接学ぶ代わりに、入力 (x) に対する差分(残差) F(x):=H(x)−xを学習し、出力を y=F(x,{Wi})+xとして入力を足し戻します。このスキップ接続により、恒等写像に近い解を作りやすくなって最適化が安定し、非常に深いネットでも学習が進みます。形状が変わる箇所では1×1畳み込み等で次元を合わせる射影ショートカットを用います。さらに50層以上では1×1→3×3→1×1のボトルネックで計算量を抑えつつ深層化し、ImageNetなどで深さに応じた精度向上を実証しました。
Kaiming He, Xiangyu Zhang, Shaoqing Ren, Jian Sun(2015)”Deep Residual Learning for Image Recognition”

DQN
DQN(Deep Q-Network)は、Q-learningにおける行動価値関数(Q値)を深層ニューラルネットワーク(CNN)で近似し、画像の画素情報から行動価値をエンドツーエンドで学習する深層強化学習の手法です。
DQNでは、行動価値関数をパラメータ θ を持つニューラルネットワーク `Q(s, a; θ)` で近似し、基本的にはQ値が最大となる行動を選択します。学習中は探索のため、一定の確率でランダムな行動を選ぶε-greedy法を用います。
Atariゲームでは、210×160ピクセルのゲーム画面を84×84ピクセルのグレースケール画像に前処理し、直近4フレームを重ねたものを状態として入力します。ネットワークは各行動に対応するQ値を一括で出力し、その中から最大のQ値を持つ行動を選択します。
しかし、深層ニューラルネットワークとQ-learningを組み合わせると学習が不安定になりやすいため、DQNでは主に次の2つの手法を用いて学習を安定化させています。
(1)経験再生(Experience Replay)
環境との相互作用で得られた状態・行動・報酬・次状態の遷移データ `(s, a, r, s’)` をリプレイメモリに保存し、そこからランダムにミニバッチを抽出して学習します。これにより、データ間の時系列的な相関を弱め、学習データの偏りを緩和します。
(2)ターゲットネットワーク(Target Network)
Q値の更新目標となるベルマンターゲットを計算するために、学習用のオンラインネットワークとは別のネットワークを用意します。ターゲットネットワークのパラメータは一定期間固定し、一定ステップごとにオンラインネットワークの重みをコピーして更新します。これにより、学習目標の急激な変動を抑え、学習を安定化させます。
さらに、報酬を一定範囲に制限する報酬クリッピングなどの工夫も取り入れることで、DQNは共通のアルゴリズムを用いて多数のAtariゲームで高い性能を達成しました。
Volodymyr Mnih et al. (2015)“Human-level control through deep reinforcement learning”

AlphaGo
AlphaGoは囲碁プログラムで、深層ニューラルネットとモンテカルロ木探索(MCTS)を統合して着手を決めます。核となるのは、(1) policy networkは盤面から次の着手を選択する役割を持ち、着手の確率分布を出力します。(2) value networkは盤面の位置を評価し、その局面からの勝率を推定します。これらを人間の棋譜からの教師あり学習で初期化し、その後自己対局による強化学習で「勝つ方策」へ改良します。探索ではpolicyで分岐を絞り、value(+シミュレーション)で局面評価しながら木を成長させ、最終的に最良手を選択します。この方式により、他の囲碁プログラムに対して高勝率(99.8%)を示し、欧州チャンピオン樊麾(ファン・フイ)に5戦全勝したと報告されています。
Google DeepMindのAlphaGo公式ページ

Silver, David et al. (2016) “Mastering the game of Go with deep neural networks and tree search”
Google Research Blog (2016)” Research Blog: AlphaGo: Mastering the ancient game of Go with Machine Learning”
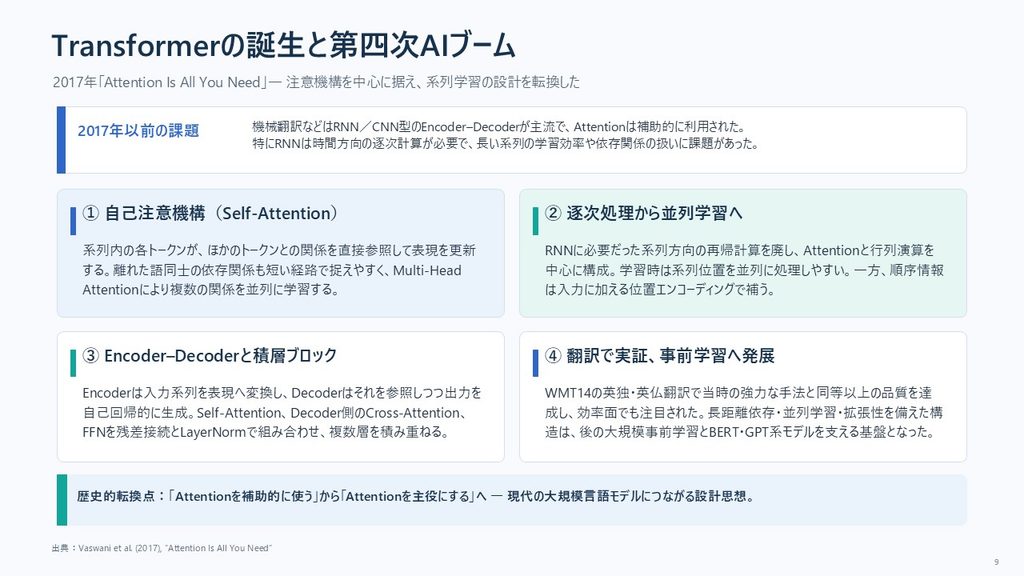
Transformerの誕生と第四次AIブーム
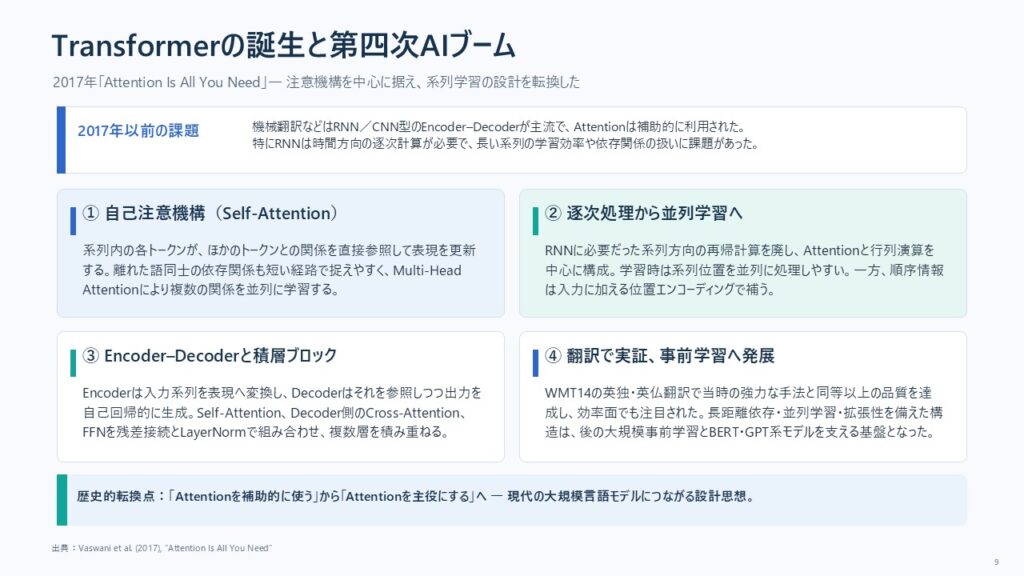
2017年以前、機械翻訳などの系列変換の主流は、RNN(やCNNをエンコーダ–デコーダとして用い、注意機構(attention)を補助的に使う構成でした。ところがRNNは逐次計算の制約が強く、長い系列では学習・推論が重くなりやすいという課題がありました。そこで「注意機構を中心に置く」発想が進み、2017年にTransformerが提案されました。
2017年“Attention Is All You Need” Transformerとその影響
2017年にアシシュ・ヴァスワニらは論文 “Attention Is All You Need” で、再帰(RNN)も畳み込み(CNN)も使わず、注意機構(attention)だけで依存関係を構成する新しいネットワークであるTransformerを提案しました。論文が主張した核心は次の3点です。
Transformerは一般的なエンコーダーとデコーダーの構造を維持します。エンコーダーが入力列 を表現列に変換し、デコーダーが 表現列を参照しながら出力列を自己回帰的に生成することで成立します。Transformerには以下の特徴があります。
- 自己注意機構(Self-Attention)により、系列内の任意トークン間を1層内で相互参照でき、長距離依存を短い経路で表現しやすい。
- RNNのような時系列方向の逐次計算が不要で、主要演算が行列積中心で、系列位置方向に並列化しやすく、学習効率が高い。
- WMT14英独・英仏などの機械翻訳ベンチマークで高いBLEUを達成し、当時の強力な既存手法と同等以上の品質を示した。
Transformerは単に「注意機構(attention)を使った」だけでなく、注意機構(attention)を主役に据えた構造設計が新規性でした。特に重要なのは以下です。
- Multi-Head Attention:複数ヘッドで異なる表現部分空間に射影して注意を計算し、単一の注意より多様な関係を並列に扱えることを意図しています。
- TransformerはRNNのように順序に沿った逐次計算をしないため、入力埋め込みに位置エンコーディングを加えて順序情報を与えます。
- 積層ブロック構造:Self-Attention/(DecoderではCross-Attention)とFFNにResidual+LayerNormを組み合わせた層をN回積層する構成を提示した。
この結果、「長距離依存を扱える」「学習が速い」「スケールしやすい」という性質が揃い、後の大規模事前学習に極めて相性が良い基盤になりました。Transformerの影響が決定的になったのは、事前学習→微調整の大波と結びついたからです。
Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, Illia Polosukhin(2017),” Attention Is All You Need”

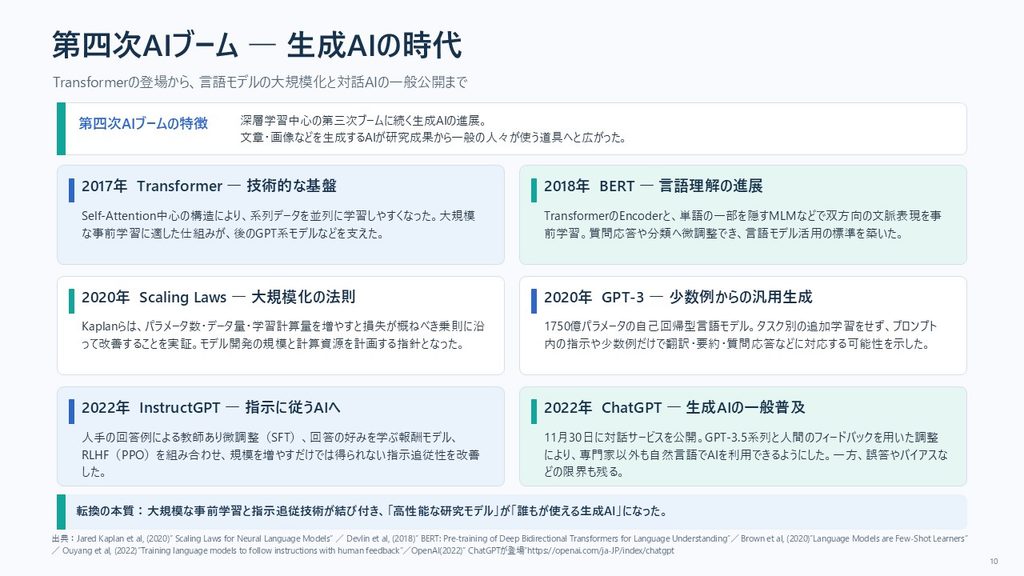
第四次AIブーム(生成AIの時代)
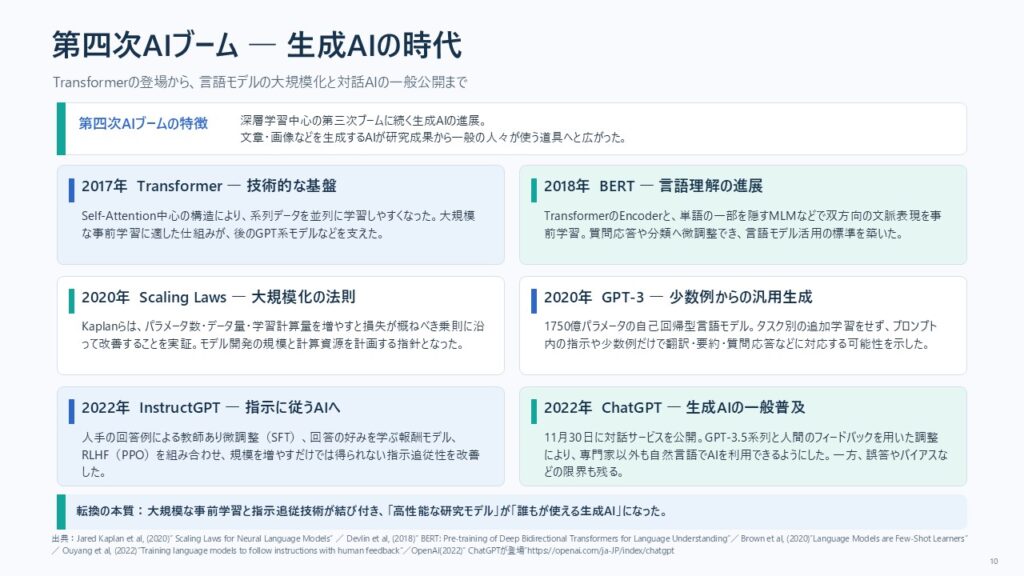
日本の公的資料でも、2010年頃からの深層学習中心の第三次ブームに続き、「生成AI技術の進展」により第4次ブームに差し掛かったと説明されています。(文部科学省”令和6年版 科学技術・イノベーション白書”,5頁)ここでの生成AIは、文章・画像などを生成できるAI(LLMや拡散モデル等)を指します。Transformerによって新たに生成AIの時代が切り開かれた結果です。
Transformerは「再帰や畳み込みなしで、注意機構(attention)だけで系列変換が成立する」アーキテクチャとして提案され、並列化しやすく大規模学習に強いことが示されました。
これにはジャレッド・カプランらによるScaling Laws for Neural Language Modelsがあります。これは大規模言語モデルの性能が「どれだけ大きくすれば、どれだけ良くなるか」を経験則として論文で定量化しました。Transformer系の言語モデルを幅広い規模で学習し、性能指標(主にクロスエントロピー損失)が、(1)モデル規模(パラメータ数)、(2)学習データ量(トークン数)、(3)学習計算量(FLOPs)に対して、広い範囲で滑らかな「べき乗則」で改善することを大規模実験で示しました。
さらに、過学習の起き方や学習曲線の形も規則的に近似できるため、固定の計算予算の下で「モデルをどれだけ大きくし、どれだけのデータで、どこまで学習するか」を最適化問題として設計できると提案します。これによりLLM開発は、勘や試行錯誤だけでなく、スケール計画と投資配分を定量的に見積もる枠組みを得ました。
なお後年本論文がスケーリング則という共通言語を確立し、投資・計画・比較を可能にした影響は現在も大きいと位置づけられます。
Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B. Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu, Dario Amodei(2020)” Scaling Laws for Neural Language Models”,

生成AIブームの“決定打”として技術が「研究成果」から「日常で使える道具」になったのが大きいです。
BERT
BERT(Bidirectional Encoder Representations from Transformers)は、Transformerのエンコーダを用いて、大量の未ラベル文書から「左右の文脈を同時に使う深い双方向表現」を事前学習し、下流タスクへは出力層を1つ追加する程度でファインチューニングできるよう設計された言語表現モデルです。
事前学習では、入力の一部を隠して当てるMasked Language Model(MLM)と、文に対して文が続き文かを判定するNext Sentence Prediction(NSP)を併用し、分類・推論・質問応答など多様なタスクへ転用しやすい表現を獲得します。
結果として、GLUEやMultiNLI、SQuADなど複数ベンチマークで当時の最先端性能を報告し、「事前学習+ファインチューニング」をNLPの標準的手順として強く定着させました。
Jacob Devlin, Ming-Wei Chang, Kenton Lee, Kristina Toutanova(2018)” BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding”

GPT-3
GPT-3は、論文”Language Models are Few-Shot Learners”で提案された、GPT-2系のTransformerのデコーダを使った自己回帰型の大規模化言語モデルです。この論文では125M〜175Bまで8サイズを学習し、最大の175BモデルをGPT-3と呼んでいます。
全モデルは2048トークンの文脈長を用い、総計3000億トークンで学習しました。 本論文の核は、タスクごとの追加学習(ファインチューニング)を行わず、入力プロンプトに指示や少数例(few-shot)を含めるだけで多様な課題に対応でき、モデルをスケールするほどzero-shot /one-shot /few-shot性能が向上することを示した点です。
Tom B. Brown, Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, Pranav Shyam, Girish Sastry, Amanda Askell, Sandhini Agarwal, Ariel Herbert-Voss, Gretchen Krueger, Tom Henighan, Rewon Child, Aditya Ramesh, Daniel M. Ziegler, Jeffrey Wu, Clemens Winter, Christopher Hesse, Mark Chen, Eric Sigler, Mateusz Litwin, Scott Gray, Benjamin Chess, Jack Clark, Christopher Berner, Sam McCandlish, Alec Radford, Ilya Sutskever, Dario Amodei(2020)”Language Models are Few-Shot Learners”

InstructGPT
InstructGPTは論文”Training language models to follow instructions with human feedback”で提示されました。InstructGPTによって「ただ賢いだけのAI」を「人の指示に従えるAI」に変えました。GPT-3 のような大規模言語モデルは大きくしても、そのままではユーザーの意図にうまく従わない問題点があります。そこでこの研究では、モデルを「人間の指示に合わせる」方法として、RLHF(人間のフィードバックによる強化学習)を使います。手順は3段階です。①人間が作成した「プロンプトと正解回答」のペアを使って、それで GPT-3 を教師あり微調整(SFT, Supervised Fine-Tuning)します。②モデルが出力した複数の回答を人間が順位付けし、その好みを予測する報酬モデル(Reward Model、RM)を学習します。③その報酬モデルを使って 近接方策最適化(PPO, proximal policy optimization)による最適化を行い、「人間が好む答え」を出しやすいモデルにします。これが InstructGPT です。
この手法で、評価用のプロンプト分布での人手評価において、GPT-3よりも遥かに少ないパラメータ数(13億パラメータモデルなど)でも、1750億パラメータのGPT-3より人間にとって好ましい回答ができるようになりました。これが後のChatGPTの同系列の技術(RLHF等)が引き継がれました。
Long Ouyang, Jeff Wu, Xu Jiang, Diogo Almeida, Carroll L. Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, John Schulman, Jacob Hilton, Fraser Kelton, Luke Miller, Maddie Simens, Amanda Askell, Peter Welinder, Paul Christiano, Jan Leike, Ryan Lowe(2022)”Training language models to follow instructions with human feedback”

ChatGPT
ChatGPTは、会話形式でユーザーの質問に答えたり、追加の質問に応じて説明を深めたりできる対話モデルです。回答の中で誤りを認めて修正したり、前提が誤っている場合に指摘したり、不適切な依頼を拒否するよう設計されています。
前述のInstructGPTと同じ手法を用い、教師あり学習の後に人間のフィードバックによる強化学習(RLHF)で微調整したと説明しています。
サービスの一番始めは2022年初頭に学習を終了したGPT-3.5系列を基にしたモデルを用いています。また限界として「もっともらしい誤答」や言い回しへの過敏さ、冗長さ、有害な指示への対応やバイアス、不正確さなどの限界が残る点も明示し、公開を通じて継続的に改善する姿勢を示しています。
OpenAI(2022年11月30日)” ChatGPT が登場”